
Im September 2025 hat Google einen URL-Parameter stillgelegt, den die meisten SEOs nie bewusst benutzt haben. &num=100 war der technische Trick, mit dem Rank-Tracker wie Semrush oder AccuRanker 100 Suchergebnisse in einem einzigen Request abgreifen konnten. Zwischen dem 10. und 14. September 2025 hörte &num=100 bei Google auf zu wirken. Danach sahen auch die Zahlen in der Google Search Console auffällig aus.
Tyler Gargula von der Locomotive Agency hat 319 Search-Console-Properties ausgewertet und die Zahlen auf LinkedIn veröffentlicht. 87,7 % der Websites verloren Impressionen, 77,6 % verloren Keywords, für die sie überhaupt rankten. Search Engine Land hat die Auswertung aufgegriffen.
Die Analyse der Locomotive Agency beschreibt, wie Rank-Tracker Bot-Impressionen auf den Positionen 50 bis 100 auslösen. Ohne diese Impressionen sieht die durchschnittliche Position besser aus. Laut Locomotive hat sich die tatsächliche Suchleistung wahrscheinlich nicht verändert.
Die erste Reaktion auf den Impressionen-Einbruch ist oft: „Alles halb so wild, war nur ein Reporting-Artefakt.“ Technisch stimmt das. Strategisch ist es für mich ein Anlass, die Indexierung über Google hinaus zu prüfen.
Inhalt
Was &num=100 eigentlich gekillt hat
Der Parameter sparte Rank-Trackern Anfragen. Ein einziger Request zeigte, wo eine Domain in den Top 100 für ein Keyword stand. Ohne &num=100 muss dasselbe Tool jetzt zehn Anfragen absetzen, um an dieselben Daten zu kommen. Laut Locomotive Agency kann das die Kosten bis zum Zehnfachen erhöhen. Was das für den Cost of Retrieval bedeutet, zeigt sich besonders bei großen Keyword-Sets und Enterprise-Setups.
Semrush und AccuRanker haben Störungen öffentlich bestätigt, Search Engine Land hat den Verlauf dokumentiert. Google sagte dazu nur, der Parameter sei nichts, was Google offiziell unterstütze. Eine Begründung nannte Google nicht.
Erstens dürfte Google Scraper loswerden wollen. Rank-Tracker belasten die Suche dauerhaft, ohne Anzeigen zu klicken. Nach meiner Einschätzung wird das Ausliefern der Suchergebnisse mit AI Overviews für Google eher teurer. &num=100 war der bequemste Weg für Scraper, Daten in Masse billig abzugreifen. Damit war dann Schluss.
Zweitens trifft die Abschaltung nach meiner Einschätzung auch LLM-Anbieter, die Google-Ergebnisse über Scraping-Dienste beziehen. Ein typischer Zweck ist Grounding (eine KI sichert ihre Antwort mit aktuellen Suchergebnissen ab). Ob LLM-Anbieter von &num=100 bei Google profitierten, ist nicht belegt.
Für mich ist das ein klares Signal, dass Google seinen Index nicht mehr billig abgreifen lassen will. Wer Rankingdaten will, hängt von Diensten ab, die Google jetzt seitenweise abfragen.
Warum Google-Only-Indexing für LLMs nicht reicht
Welche LLMs (Large Language Models, also Sprachmodelle) nutzen Googles Index überhaupt?
Von den gängigen LLMs ist Gemini direkt an die Google-Suche angebunden und sichert seine Antworten per Grounding mit Google-Ergebnissen ab. Meta AI sucht laut Search Engine Journal seit April 2024 neben Bing auch über Google. Le Chat sucht laut Brave über die Brave Search API. Für Claude nennt die Google-Cloud-Doku Brave als Suchdienst, Perplexity sucht über einen eigenen Index. ChatGPT nutzt für die Suche laut OpenAI externe Suchdienste und Inhalte direkter Partner.
Laut The Information nutzte OpenAI 2025 den Dienst SerpApi, der Google-Ergebnisse abgreift. Reddit wirft Perplexity in einer Klage vom Oktober 2025 vor, Google-Ergebnisse über SerpApi zu beziehen. Beides sind Bericht und Vorwurf, keine Bestätigung.
In vielen SEO-Setups, die ich sehe, hängt die Indexierung allein an Google. Teams reichen Sitemaps in der Search Console ein. Manche melden neue Seiten zusätzlich über die Google Indexing API (laut Google nur für Stellenanzeigen und Livestreams gedacht). Bing bleibt eine Randerscheinung, Brave, DuckDuckGo und Yandex fehlen meist ganz.
Aus meiner Sicht reicht eine Google-zentrierte Indexierungs-Strategie nicht mehr, wenn der eigene Content für ein LLM sichtbar sein soll. Seit der Abschaltung von &num=100 gilt das stärker.
Welcher LLM nutzt welche Suchmaschine
Die Tabelle zeigt sieben KI-Produkte und die Suchquellen, die sie für das Grounding nutzen.
| LLM / KI-Produkt | Suchquelle für Web-Grounding |
|---|---|
| ChatGPT | Suchpartner laut OpenAI, in ChatGPT Enterprise und Edu Bing, dazu Inhalte direkter Partner für Wetter, Börse, Sport und News |
| Perplexity | Eigener Crawler, eigener Index |
| Claude (via web_search) | Brave Search (laut Google-Cloud-Doku, in der Anthropic-Doku nicht genannt) |
| Gemini | Google Search (über Grounding API) |
| Meta AI | Bing und Google (Bing laut Meta seit 2023, Google laut Fachpresse seit 2024) |
| Grok (xAI) | Websuche ohne genannte Quelle, dazu Suche in Beiträgen auf X |
| Le Chat (Mistral) | Brave Search API (laut Brave seit Februar 2025) |
Abb. 1: Welches KI-Produkt über welche Suchquelle sucht. Für Claude nennt die Google-Cloud-Doku Brave, Anthropic selbst nicht. Google als Quelle von Meta AI nennt die Fachpresse. ↓ PNG
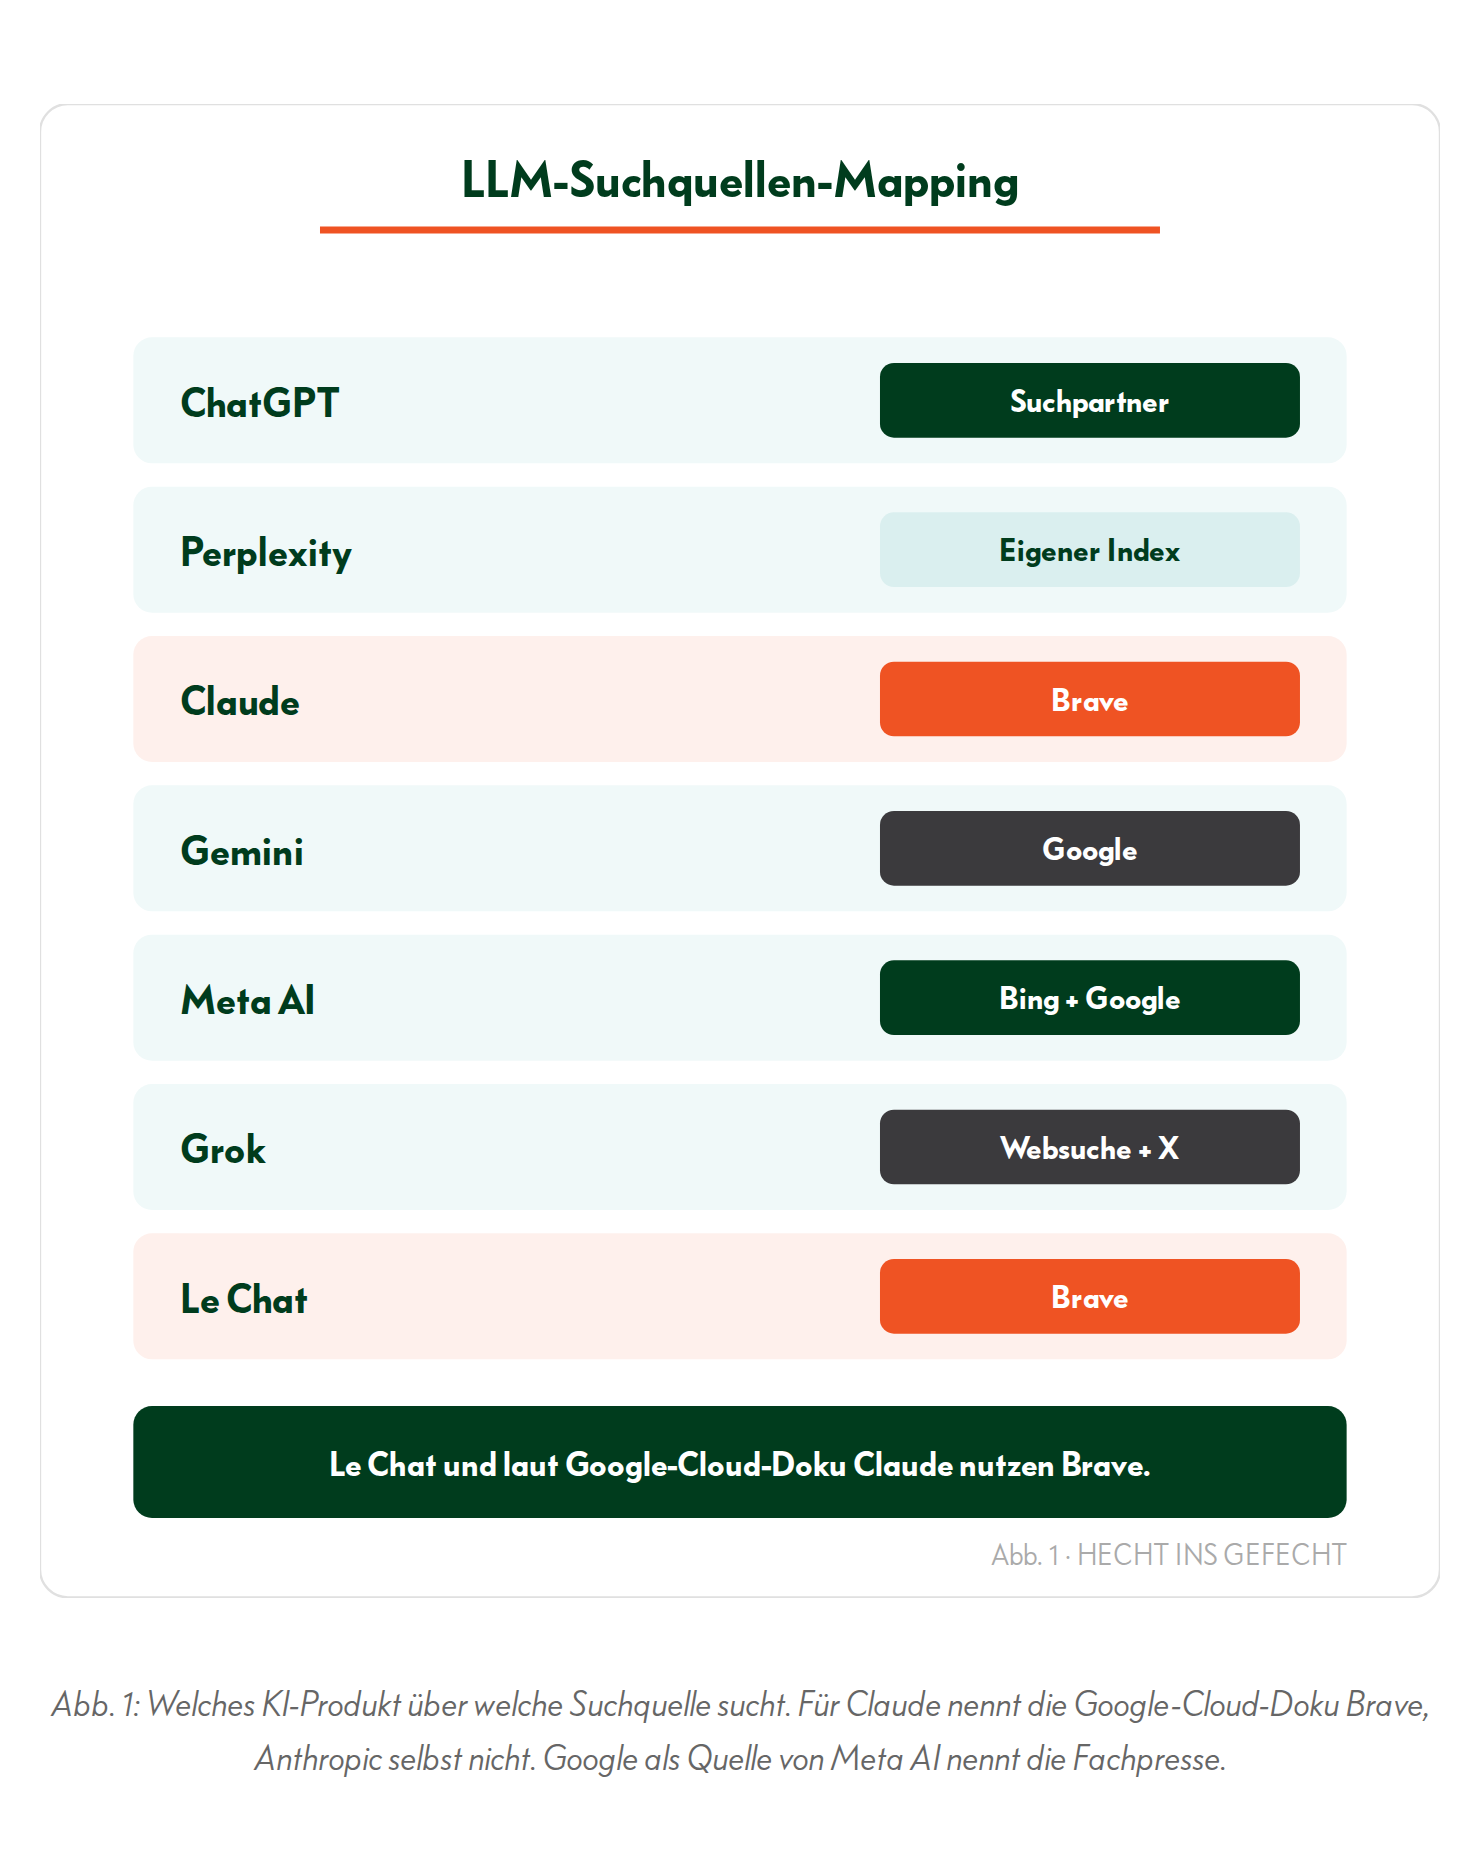
OpenAI nennt im Help Center zur ChatGPT-Suche Suchpartner, Bing steht dort nur im Artikel für ChatGPT Enterprise und Edu. Die Ankündigung der ChatGPT-Suche von 2024 spricht von „third-party search providers“ und Inhalten direkter Partner. Analysen von 2026 beschreiben zusätzlich einen eigenen Suchindex von OpenAI, bestätigt hat OpenAI das nicht.
Meta AI sucht laut Meta seit 2023 über Bing, laut Search Engine Journal seit 2024 zusätzlich über Google. Laut einer OpenAI-Sprecherin erreichte ChatGPT im Juli 2026 eine Milliarde Nutzer pro Woche. Wer in Bing fehlt, ist aus meiner Sicht bei den LLM-Produkten Meta AI sowie ChatGPT Enterprise und Edu schwerer auffindbar.
Brave Search ist die Suchquelle von Le Chat und laut Google-Cloud-Doku auch von Claude. Laut Brave liefert die Brave Search API Le Chat seit Februar 2025 Live-Ergebnisse. Die Anthropic-Doku zum web_search-Tool selbst nennt keine Suchquelle. Anthropic führt Brave Search außerdem seit März 2025 als Unterauftragsverarbeiter.
Laut einer von MERJ zitierten Auswertung von Profound stehen 79,2 % der von Claude zitierten URLs in den Top 10 von Brave. Bei Google sind es 34 %. Für die Bildersuche nennt das Anthropic Help Center Bing. In einer im Juli 2026 veröffentlichten Umfrage unter 1.999 US-Nutzern von KI-Assistenten war Claude bei Programmieraufgaben für ein Drittel der Hauptassistent, insgesamt nur für 7 %. Wer mit Inhalten zu Programmieraufgaben bei Claude auftauchen will, für den halte ich Brave für eine echte Anlaufstelle.
Laut Semrush (Clickstream-Daten eines US-Nutzerpanels) löste ChatGPT im Februar 2026 bei 34,5 % der Anfragen eine Websuche aus, Ende 2024 waren es 46 %. Bei den übrigen Anfragen antwortet das Modell aus seinem vorhandenen Wissen. Wenn die Websuche greift, muss der Abruf durch den ChatGPT-Crawler technisch erst einmal gelingen.
Wie ChatGPT Quellen auswählt und gewichtet, folgt eigenen Regeln, die mit klassischer Suchmaschinen-Indexierung nur zum Teil zusammenhängen. Wer sein Material nicht in die Trainingsdaten bekommt (Common Crawl, Webarchivierung, Publisher-Deals), fehlt in den Antworten ohne Websuche. Das gilt auch, wenn Suchmaschinen das Material indexiert haben.
Drei Indexe, drei Wege
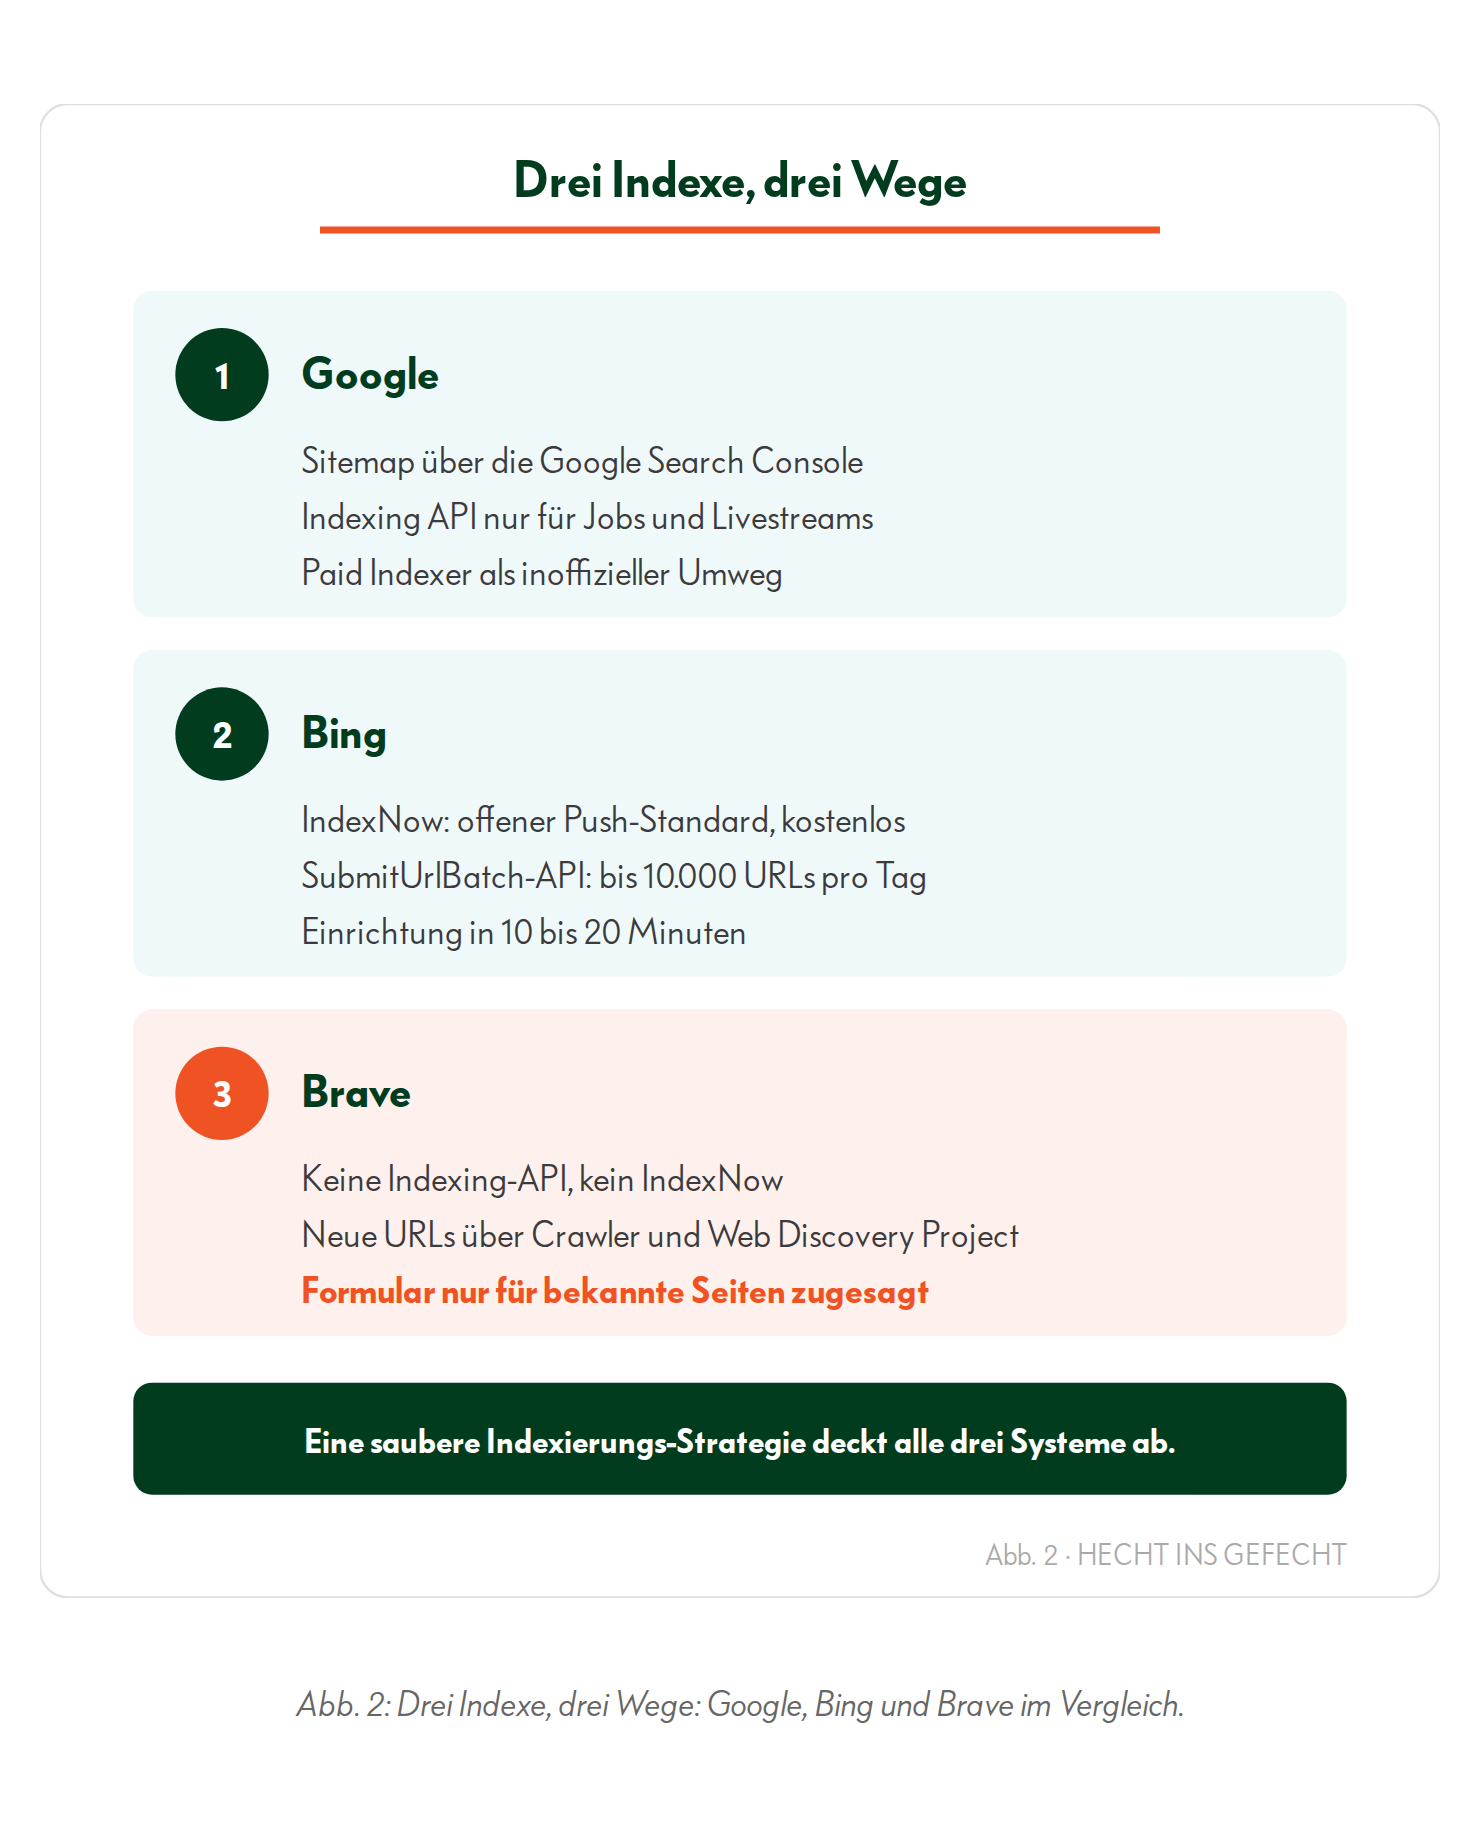
Für die Indexierung gehen Google, Bing und Brave unterschiedlich vor. Google bietet eine offizielle API nur für wenige Inhaltstypen. Bing nimmt Meldungen über IndexNow und eine eigene API an. Brave hat ein Formular für den erneuten Abruf bekannter Seiten und findet neue Seiten über eigene Wege.
Abb. 2: Drei Indexe, drei Wege: Google, Bing und Brave im Vergleich. ↓ PNG
Die klassischen Wege kennt jeder: XML-Sitemap in der Search Console einreichen, crawlbare interne Verlinkung, saubere Canonicals. Googles offizielle Indexing API ist auf zwei Content-Typen beschränkt, Jobpostings und Livestreams. Für andere Inhalte erlaubt Google die API nicht. In der Praxis nimmt die API mit der Inhaber-Berechtigung (siteOwner) in der Search Console auch andere URLs mit Status 200 an.
Ob Google sie danach schneller crawlt, zeigt die Antwort nicht. Mit vollem Nutzerzugriff (siteFullUser) antwortet die API mit 403. Bei HECHT INS GEFECHT hat ein eigenes Skript solche 403-Fehler einmal als Erfolg verbucht, deswegen solltest du die Antwortcodes immer prüfen. Google schreibt außerdem, dass Missbrauch der API zum Entzug des Zugangs führen kann.
Bei einer Klinik-Website auf WordPress enthielt die Sitemap nur 91 von 100 URLs. Ursache war eine verwaiste Cache-Datei des SEO-Plugins im Zusammenspiel mit geplanten Veröffentlichungen, bei denen die Sitemap nicht neu erzeugt wurde. Terminieren allein ist kein Problem. Zähle regelmäßig die eingereichte Sitemap gegen die live veröffentlichten URLs.
In der Praxis gibt es Paid Indexer. Das sind kostenpflichtige Dienste, die URLs über andere Kanäle an Google melden und so mehr davon in den Index bringen wollen als eine Sitemap. Ob das gelingt, zeigt der Dienst selbst nicht zuverlässig. Bei einem Indexierungsdienst stand ein Auftrag dauerhaft auf „processing“, obwohl alle URLs dieses Auftrags per site:-Abfrage indexiert waren.
Nach meiner Erfahrung sind oft 50 bis 85 % der eingereichten URLs schon im Index. Wer sie erneut einreicht, zahlt ohne Nutzen. Prüfe den Index deshalb selbst per site:-Abfrage auf die exakte URL. Für eine junge Seite mit 20 wichtigen URLs kann sich so ein Dienst rechnen, für einen Shop mit 10.000 URLs eher nicht.
Bing
Bei Bing gibt es zwei Wege für das aktive Melden. IndexNow ist ein offenes, kostenloses Protokoll, das Bing, Yandex, Seznam, Naver und weitere Suchmaschinen gemeinsam unterstützen. Google nimmt nicht teil. Ein HTTP-Request schickt eine Liste von URLs mit einem API-Key an einen Endpoint, und die Suchmaschinen holen sich die Inhalte selbst.
Wie schnell Crawler auf aktives Melden reagieren, habe ich beim SEO-Contest 2026 gemessen. Das war ein Wettbewerb von Seobility und Agenturtipp.de im Juni 2026, gestartet auf einer brandneuen Domain.
Um 20:38 Uhr habe ich die neuen URLs per IndexNow, über die Bing-API und über die Indexing API gemeldet. Der Bingbot holte die Sitemap um 21:03 Uhr ab, binnen einer Minute nach einer erneuten Einreichung in den Bing Webmaster Tools. Der Googlebot erschien um 22:02 Uhr zum ersten Mal im Log, das erst ab 21:02 Uhr lief.
Der erste Klick aus der organischen Google-Suche kam um 22:14 Uhr, das komplette Protokoll steht im Beitrag zur Google Sandbox. Der ClaudeBot rief ab dem ersten Abend etwa alle zwei Stunden robots.txt und Sitemap ab, der GPTBot tauchte bis zum nächsten Morgen nicht auf. Das aktive Melden jedes Updates auch an Google war eine bewusste Ausnahme für die frische Domain. Bei etablierten Websites reiche ich Updates nicht erneut über die Indexing API bei Google ein. Nach meiner Erfahrung kommt der Googlebot dort von selbst wieder.
Zusätzlich bieten die Bing Webmaster Tools eine eigene API namens SubmitUrlBatch. Sie erlaubt bis zu 10.000 URLs pro Tag und Domain, das tatsächliche Kontingent legt Bing je Website fest. Bing empfiehlt inzwischen IndexNow und schreibt, die API könne künftig abgeschaltet werden. Die Einrichtung dauert nach meiner Erfahrung 10 bis 20 Minuten. Wer Bing noch nicht als Indexierungs-Kanal nutzt, lässt eine einfache Möglichkeit ungenutzt.
Brave Search
Brave betreibt unter search.brave.com/submit-url ein öffentliches Formular, in das sich einzelne URLs eintragen lassen. Dafür braucht es weder einen Account noch eine Domain-Verifizierung oder einen Zugang zu den Webmaster-Tools.
Eine Ankündigung als Blogpost oder in den Release Notes hat HECHT INS GEFECHT nicht gefunden. In der Brave-Community taucht der Link spätestens im August 2024 auf. Ausführlich untersucht hat das Formular im Juli 2026 die Agentur MERJ.
Der Feldtext lautet Insert the URL to be re-fetched. Die Brave-Hilfeseiten beschreiben das Werkzeug nur für bereits bekannte Seiten. Genannt sind das Entfernen nicht mehr vorhandener Seiten, das erneute Abrufen geänderter Seiten und das Entfernen von Seiten mit neu gesetztem noindex. Eine Zusage für unbekannte URLs gibt Brave dort nicht.
HECHT INS GEFECHT hat das Formular im Juli 2026 getestet. Vom 18. bis 20. Juli 2026 reichten wir 216 URLs auf 88 Domains über das Formular ein: eigene Seiten, Kundenprojekte, Verzeichnis- und Profileinträge. Für 205 davon hatten wir vorher gemessen, dass sie nicht im Brave-Index lagen. Am 25. Juli 2026 standen 8 der 205 URLs im Index, 3,9 %. Bei zwei Domains fehlten alle eingereichten Kernseiten, 22 und 28 URLs.
Bei einer erneuten Prüfung am 9. Oktober 2026 standen 16 der 205 URLs im Index, 7,8 %. Elf kamen neu dazu, drei waren wieder herausgefallen. Bei 71 der 88 Domains stand keine einzige eingereichte URL im Index.
Einen Beweis liefert die Messung nicht, denn es gab keine Kontrollgruppe. Brave findet neue Seiten auch über den eigenen Crawler und das Web Discovery Project. Die Treffer können also auch ohne das Formular gekommen sein. Mehr als 4 % hat das Formular in der ersten Woche nicht bewirkt, nach knapp drei Monaten höchstens 7,8 %.
Eine Indexing-API im Sinne von Google oder Bing ist das Formular also nicht. IndexNow unterstützt Brave nicht. Das Web Discovery Project ist ein Meldeverfahren im Brave-Browser und standardmäßig ausgeschaltet. Für bekannte Seiten bietet das Formular immerhin einen Weg, einen erneuten Abruf anzustoßen.
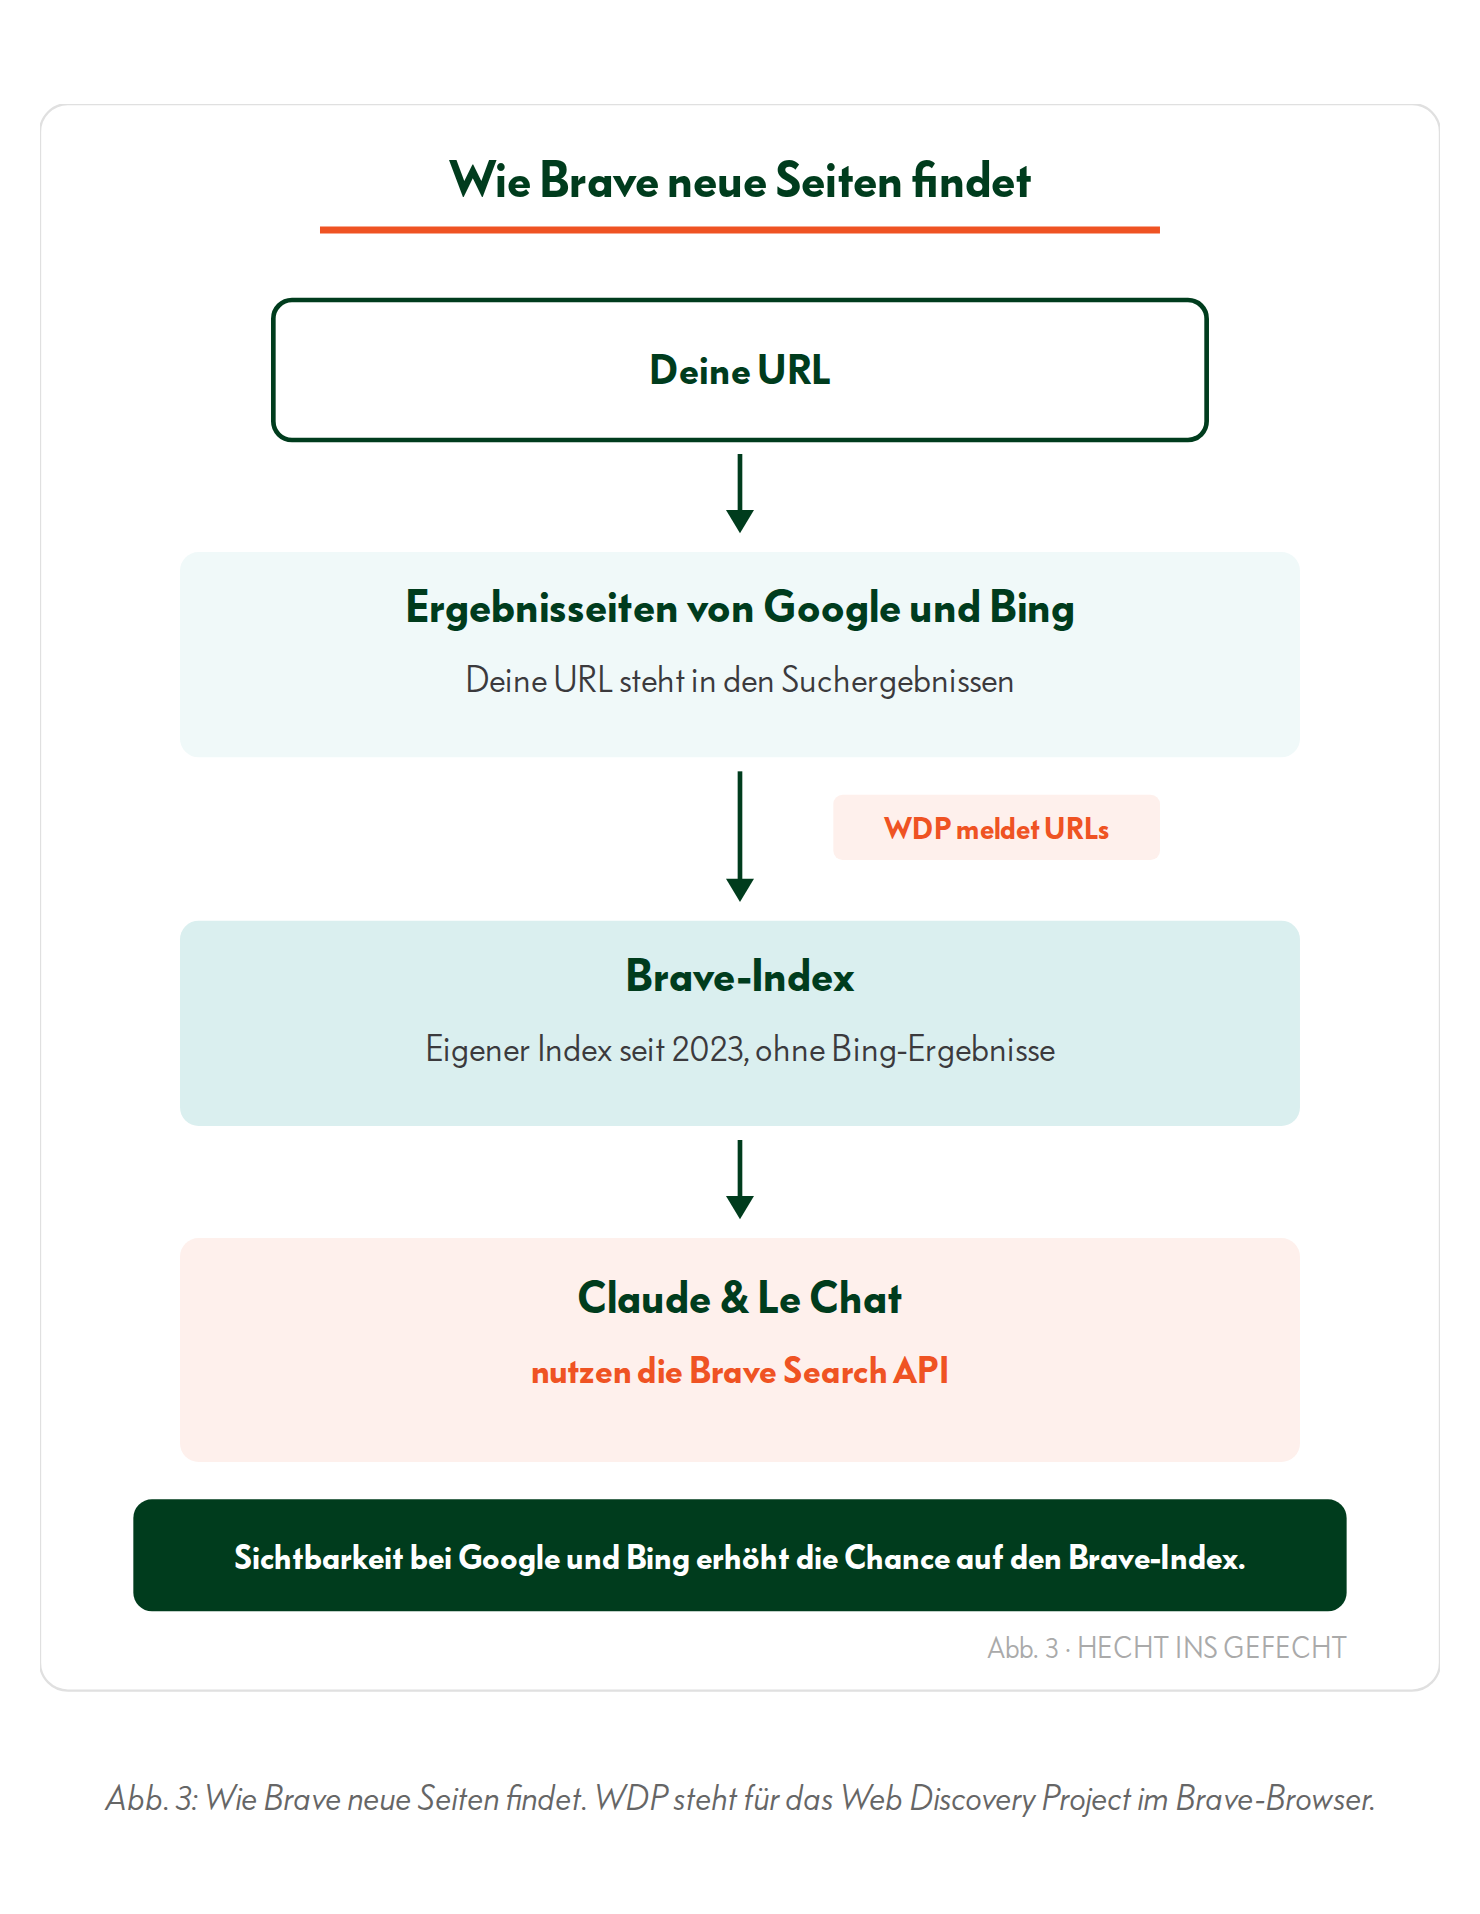
Daneben gibt es einen indirekten Weg. Brave liefert laut eigener Angabe seit April 2023 alle Ergebnisse aus dem eigenen Index und lädt keine Bing-Ergebnisse mehr. Neue Seiten findet Brave unter anderem über das Web Discovery Project (WDP). Browser mit aktiviertem WDP erkennen Ergebnisseiten von Google, Bing, Yahoo und DuckDuckGo und melden die dort gelisteten URLs anonym an Brave.
Laut MERJ reicht für eine URL auf einer solchen Ergebnisseite ein Nutzer mit einer Suche. Seiten, die nur über Besuche auffallen, brauchen rund 20 verschiedene Nutzer mit aktiviertem WDP. Nach meiner Einschätzung wird deshalb eher entdeckt, wer bei Google und Bing gut sichtbar ist. Über die Brave Search API landen die Seiten dann in Le Chat und laut der Google-Cloud-Doku zu Claude-Modellen auch in Claude.
Für Claude und Le Chat zählt damit der Brave-Index selbst. Eine gute Sichtbarkeit bei Google und Bing kann den Weg dorthin verkürzen.
Abb. 3: Wie Brave neue Seiten findet. WDP steht für das Web Discovery Project im Brave-Browser. ↓ PNG
Der Citation-Check als Audit-Tool
Seit April 2026 prüft HECHT INS GEFECHT für Kunden, in welchen von fünf Suchmaschinen (Google, Bing, Brave, Yandex, DuckDuckGo) ihre Brand-Citations bei Suchen nach dem Markennamen auftauchen. Citations sind Erwähnungen der Marke auf fremden Seiten, etwa in Bewertungsportalen, Verzeichnissen, Profilen oder in der Presse.
Ausgewertet sind zehn Kundenmarken mit zusammen 936 Citations, die der Scan eindeutig einer Kategorie zuordnen konnte. Davon tauchten 91 % in höchstens zwei der fünf Suchmaschinen auf, in allen fünf nur zehn. Bei Index-Checks von HECHT INS GEFECHT fehlten etwa Trustpilot-Seiten, Branchenverzeichnisse oder die eigene LinkedIn-Unternehmensseite.
Wer eine Marke in LLMs stärken will, sollte nach meiner Einschätzung dafür sorgen, dass jede wichtige Citation in allen relevanten Suchmaschinen auftaucht. Fehlt sie in Brave, zitiert Claude womöglich eine andere Quelle, auch wenn deine bei Google auf Seite 1 steht.
Vier Schritte für mehr Sichtbarkeit in LLMs durch gezielte Indexierung
Abb. 4: Vier Schritte zu besserer LLM-Sichtbarkeit durch gezielte Indexierung. ↓ PNG
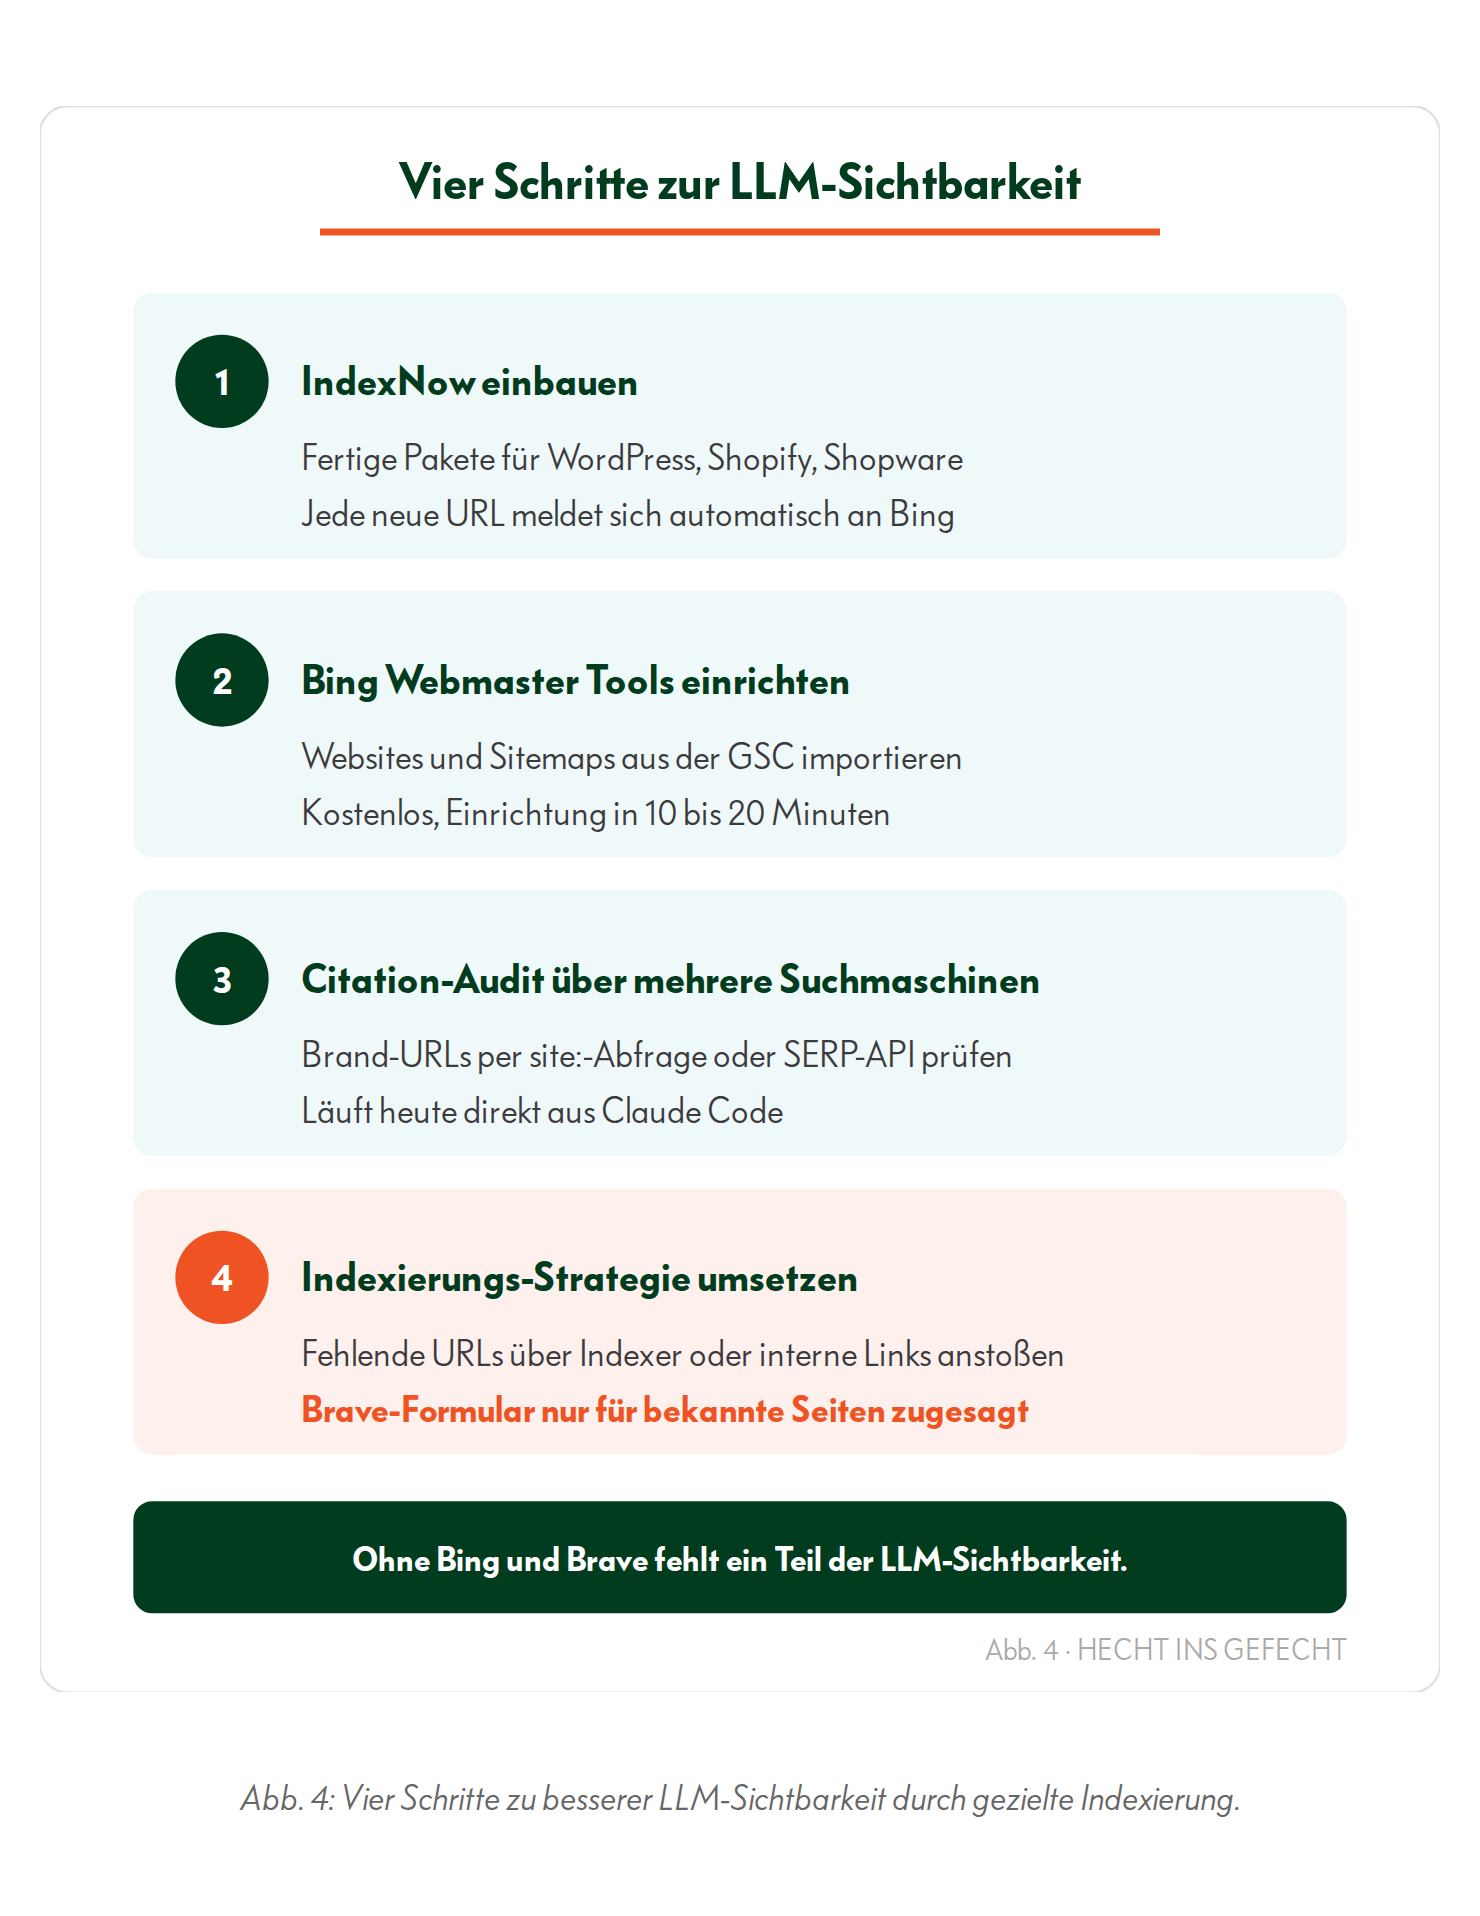
- IndexNow einbauen. Aus meiner Sicht bringt dieser Schritt am meisten für den geringsten Aufwand. Für WordPress, Shopify, Shopware und viele Headless-Setups gibt es fertige Pakete. Jede neue URL und jede Content-Änderung wird automatisch an Bing und die anderen IndexNow-Suchmaschinen gemeldet.
- Bing Webmaster Tools einrichten. Websites, Rollen und Sitemaps direkt aus der Google Search Console importieren und das Crawl-Verhalten wöchentlich in den Bing Webmaster Tools prüfen. Die Einrichtung ist kostenlos und dauert nach meiner Erfahrung 10 bis 20 Minuten.
- Citation-Audit über fünf Suchmaschinen. Sammle die wichtigsten Brand-URLs (Pressemeldungen, Profile, Verzeichnisse, eigene Landingpages) und prüfe per site:-Abfrage oder über eine SERP-API, wo sie indexiert sind. Das habe ich früher manuell in den einzelnen Suchmaschinen gemacht. Mittlerweile läuft das bei HECHT INS GEFECHT über Such-APIs direkt in Claude Code.
- Indexierungs-Strategie umsetzen. Danach bringst du die fehlenden Brand-URLs aus dem Citation-Audit in den Index der jeweiligen Suchmaschinen. Da helfen Indexer-Dienste oder das Verlinken auf der eigenen Seite, die du bei Google und Bing zur Indexierung einreichst. Für Brave kannst du zusätzlich das Formular unter search.brave.com/submit-url nutzen, aber Brave sagt dafür nur den erneuten Abruf bekannter Seiten zu. Im Test von HECHT INS GEFECHT standen nach knapp drei Monaten nur 7,8 % der vorher fehlenden URLs im Index. Ob das Formular sie gebracht hat, ist offen.
Google allein reicht nicht mehr
Die &num=100-Entfernung lese ich als Richtungswechsel. Google macht den eigenen Index für Scraper teurer und schwerer abgreifbar. Gleichzeitig baut Google die Suche mit LLM-Features wie AI Overviews und dem AI Mode um.
Wer in KI-Assistenten auftauchen will, sollte Bing und Brave in die Indexierung einbeziehen. Das gehört aus meiner Sicht zur Grundlage für LLM-Sichtbarkeit. Der Mehraufwand bleibt überschaubar, sobald die Indexierung einmal sauber aufgesetzt ist.
Der Gedanke bleibt letztlich derselbe, den gutes technisches SEO schon lange verfolgt hat. Mach Inhalte für die Suchmaschinen und LLMs auffindbar, die deine Zielgruppe benutzt.
Häufige Fragen zur Indexierung für LLMs
Wie lange dauert die Indexierung bei Google?
Die Google-Indexierung dauert je nach Domain-Autorität und Crawl-Budget zwischen einigen Stunden und mehreren Wochen. Google selbst nennt für das Crawlen nach einer Anfrage einige Tage bis einige Wochen. Nach meiner Erfahrung crawlt Google neue Seiten auf etablierten Domains oft schon nach 24 bis 48 Stunden. Ein noindex-Tag hält eine Seite aus dem Index, wenn Google es lesen kann. Eine robots.txt-Sperre blockiert dagegen nur das Crawlen und verhindert sogar, dass Google das noindex liest. So rankte bei einem Onlineshop ein per robots.txt gesperrtes PDF über Monate in der Google-Suche. Bei Bing beschleunigst du die Indexierung über IndexNow, bei Google wartest du auf den Crawler. Im Praxistest auf einer brandneuen Domain erschien Googlebot knapp 90 Minuten nach der Meldung per Indexing API im Log, der erste organische Klick kam noch am Launch-Abend.
Was ist der &num=100-Parameter und warum hat Google ihn entfernt?
&num=100 war ein URL-Parameter in der Google-Suche, der bis zu 100 Ergebnisse pro Seite ausgeliefert hat statt der üblichen 10. Rank-Tracker haben den Parameter genutzt, um Suchrankings effizient zu erfassen. Zwischen dem 10. und 14. September 2025 hörte der Parameter auf zu wirken. Google sagte nur, er werde offiziell nicht unterstützt, eine Begründung nannte Google nicht. Ich halte zwei Motive für plausibel, Scraper auszubremsen und LLM-Anbietern den günstigen Abgriff von Google-Ergebnissen zu erschweren.
Warum sind meine Google-Search-Console-Impressionen seit September 2025 eingebrochen?
Eine Ursache ist die &num=100-Entfernung. Rank-Tracker haben bei jeder Abfrage Impressionen auf tiefen Positionen (50 bis 100) ausgelöst, die nie von echten Nutzern gesehen wurden. Die Bot-Impressionen fallen jetzt weg, die tatsächliche Suchleistung hat sich laut Locomotive Agency wahrscheinlich nicht verändert. Nach der Behebung eines Protokollierungsfehlers kann ein weiterer Rückgang dazukommen. Der Fehler betraf Impressionen vom 13. Mai 2025 bis 27. April 2026, Klicks waren nicht betroffen. In einer Auswertung von Tyler Gargula (Locomotive Agency) über 319 Search-Console-Properties verloren 87,7 % der Websites Impressionen.
Welche Suchmaschine nutzt ChatGPT für die Websuche?
Laut OpenAI nutzt ChatGPT für die Suche externe Suchdienste, Bing nennt OpenAI nur für ChatGPT Enterprise und Edu. Für Wetter, Börse, Sport, News und Karten kommen Inhalte direkter Partner dazu. Laut Semrush (Clickstream-Daten eines US-Nutzerpanels) löste ChatGPT im Februar 2026 bei 34,5 % der Anfragen eine Websuche aus, Ende 2024 waren es 46 %. Die übrigen beantwortet das Modell aus seinem vorhandenen Wissen.
Wie kann ich URLs bei Bing indexieren lassen?
Für das aktive Melden bei Bing gibt es zwei Wege. IndexNow ist der offene Push-Standard, der mit einem einfachen HTTP-Request URLs an Bing, Yandex und weitere Suchmaschinen meldet. Zusätzlich bieten die Bing Webmaster Tools die SubmitUrlBatch-API mit bis zu 10.000 URLs pro Tag und Domain. Das tatsächliche Kontingent legt Bing je Website fest. Bing empfiehlt inzwischen IndexNow und schreibt, die API könne künftig abgeschaltet werden. Beide Wege sind kostenlos und nach meiner Erfahrung in 10 bis 20 Minuten eingerichtet.
Wie bekomme ich meine Seite in Brave Search?
Ein Formular unter search.brave.com/submit-url gibt es ohne Account und ohne Domain-Verifizierung, Brave sagt dafür aber nur den erneuten Abruf bekannter Seiten zu. Im Test von HECHT INS GEFECHT standen knapp drei Monate nach dem Einreichen 7,8 % der vorher fehlenden URLs im Index. Ob sie durch das Formular kamen, ist offen. Neue Seiten findet Brave über den eigenen Crawler, und Nutzer mit aktiviertem Web Discovery Project melden URLs von Ergebnisseiten anderer Suchmaschinen. Eine Indexing API oder IndexNow bietet Brave nicht. Le Chat sucht laut Brave über den Brave-Index, laut der Google-Cloud-Doku zu Claude-Modellen auch Claude.
Welcher LLM nutzt welche Suchquelle?
ChatGPT nutzt laut OpenAI externe Suchdienste und Inhalte direkter Partner, Bing nennt OpenAI nur für ChatGPT Enterprise und Edu. Meta AI nutzt laut Meta Bing, laut Fachpresse seit 2024 auch Google. Le Chat nutzt laut Brave die Brave Search API, Claude laut der Google-Cloud-Doku zu Claude-Modellen ebenfalls Brave, die Anthropic-Doku nennt keine Suchquelle. Perplexity setzt auf einen eigenen Crawler und einen eigenen Index, Gemini auf die Google-Suche. Grok nutzt eine Websuche ohne genannte Quelle und eine Suche in Beiträgen auf X. Nach meiner Einschätzung zählt für die Sichtbarkeit in LLMs die Indexierung bei Google, Bing und Brave, zudem sollte PerplexityBot in der robots.txt nicht gesperrt sein.
Quellen
- Locomotive Agency (15.09.2025): Google Removes &num=100 Parameter September 2025: Search Console Data Changes Explained, Zeitraum der Änderung, Bot-Impressionen, Kostenfaktor.
- Search Engine Land (18.09.2025, Danny Goodwin): 77% of sites lost keyword visibility after Google removed num=100, Auswertung von Tyler Gargula über 319 Properties.
- Google Search Console-Hilfe: Data anomalies in Search Console, Protokollierungsfehler bei Impressionen vom 13.05.2025 bis 27.04.2026.
- Search Engine Land (26.08.2025, Danny Goodwin): ChatGPT’s answers came from Google Search after all, Bericht von The Information zu OpenAI und SerpApi.
- Reddit (22.10.2025): Klage Reddit v. SerpApi, Vorwürfe gegen SerpApi, Oxylabs, AWMProxy und Perplexity.
- OpenAI (31.10.2024): Introducing ChatGPT search, Suchanbieter und Inhalte direkter Partner.
- OpenAI Help Center: ChatGPT search, Suchpartner.
- OpenAI Help Center: ChatGPT search for Enterprise and Edu, Bing für Enterprise und Edu.
- Semrush (03.02.2025, aktualisiert 07.04.2026): ChatGPT traffic analysis: Insights from 17 months of clickstream data, Anteil der Anfragen mit Websuche Ende 2024 und Februar 2026.
- The Verge (11.08.2026): ChatGPT and Gemini both just passed 1 billion users, ChatGPT laut OpenAI-Sprecherin im Juli 2026 bei einer Milliarde Nutzern pro Woche.
- Search Engine Land (17.08.2026, Olivier de Segonzac): Inside ChatGPT’s retrieval stack: The index, cache, and pages it actually reads, eigener Index von OpenAI laut Analyse.
- Meta (27.09.2023): Introducing New AI Experiences Across Our Family of Apps and Devices, Suchpartnerschaft mit Bing.
- Search Engine Journal (19.04.2024, Matt G. Southern): Meta Integrates Google & Bing Search Results Into AI Assistant.
- Anthropic Docs: Web search tool, ohne Angabe der Suchquelle.
- Google Cloud Docs: Web search with Anthropic Claude models, Brave Search als Suchdienst der Claude-Websuche.
- Simon Willison (21.03.2025): Anthropic Trust Center: Brave Search added as a subprocessor.
- TechCrunch (21.03.2025): Anthropic appears to be using Brave to power web search for its Claude chatbot, auch Le Chat mit der Brave Search API.
- Claude Help Center: Enable and use web search, Bildersuche über Bing.
- Zou, J. (arXiv, 16.07.2026): Platform Choice, Trust, and Privacy in the Consumer AI Assistant Market, Umfrage unter 1.999 US-Nutzern von KI-Assistenten (Preprint).
- Perplexity (25.09.2025): Architecting and evaluating an AI-first Search API, eigener Crawler, Index mit über 200 Milliarden URLs.
- Google AI for Developers: Grounding with Google Search.
- xAI Docs: Web Search, Websuche und Suche auf X.
- Brave (27.04.2023): Brave Search removes last remnant of Bing from search results page, achieving 100% independence and providing real alternative to Big Tech search.
- Brave Search API: brave.com/search/api, Suchschnittstelle auf Basis des Brave-Index.
- Brave Search: Submit URL, Formular für den erneuten Abruf bekannter Seiten, eigener Praxistest Juli und Oktober 2026.
- Brave Search Hilfe: Brave Search Crawler.
- Siddle, R. & Blyskal, J. (MERJ, 09.07.2026): How Brave Search discovers new pages: A deep dive into the Web Discovery Project, Code-Inspektion von Submit-Formular und Web Discovery Project.
- IndexNow: indexnow.org, Protokoll-Spezifikation, teilnehmende Suchmaschinen.
- Microsoft Bing: IndexNow bei Bing, Bing-spezifische Implementierung.
- Bing Webmaster Tools: Hilfe zur URL-Einreichung, Kontingent der SubmitUrlBatch-API.
- Bing Webmaster Tools: Hilfe zum Hinzufügen und Verifizieren von Websites, Import aus der Google Search Console.
- Google Indexing API: Indexing API Quickstart, Beschränkung auf Jobposting und Livestream, Entzug des Zugangs bei Missbrauch.
- Google Search Central: Ask Google to Recrawl Your Website, Dauer des Crawlings nach einer Anfrage.
- Eigene Messungen HECHT INS GEFECHT: Citation-Scans über fünf Suchmaschinen (April bis September 2026), Index-Checks über fünf Suchmaschinen (ab April 2026), Test des Brave-Formulars (Juli und Oktober 2026), Server-Log zum SEO-Contest 2026.