---
title: "Crawl Budget und Cost of Retrieval: Was das Crawlen deiner Website kostet"
description: "Crawl Budget erklärt: warum Google deine Seiten selten crawlt, was der Abruf kostet und wie du das Budget schonst. Zahlen aus über 30 Audits."
url: https://hechtinsgefecht.de/cost-of-retrieval/
date_published: 2026-03-10
date_modified: 2026-10-09
organization: HECHT INS GEFECHT
organization_url: https://hechtinsgefecht.de
organization_knowledge_graph_id: /g/1pp2twrtc
organization_sameas:
- https://www.northdata.de/HECHT+INS+GEFECHT+GmbH,+Bremen/HRB+42926
- https://firmeneintrag.creditreform.de/28309/2051250968/HECHT_INS_GEFECHT_GMBH
- https://www.companyhouse.de/HECHT-INS-GEFECHT-GmbH-Bremen
- https://implisense.com/de/companies/hecht-ins-gefecht-gmbh-bremen--DETQXQBC7O52
- https://www.linkedin.com/company/hechtinsgefecht
- https://www.xing.com/pages/hecht-ins-gefecht/
- https://social.hechtinsgefecht.de/@hig
- https://x.com/hechtinsgefecht
- https://www.facebook.com/HechtinsGefecht/
- https://www.instagram.com/hechtinsgefecht/
- https://de.pinterest.com/HechtinsGefecht/
- https://www.threads.com/@hechtinsgefecht
- https://www.crunchbase.com/organization/hecht-ins-gefecht-digitalagentur-f%C3%BCr-webdesign-seo
- https://clutch.co/profile/hecht-ins-gefecht
- https://www.designrush.com/agency/profile/hecht-ins-gefecht
- https://agencies.semrush.com/hecht-ins-gefecht/
- https://www.sortlist.de/agency/hecht-ins-gefecht
- https://www.goodfirms.co/company/hecht-ins-gefecht
- https://techbehemoths.com/company/hecht-ins-gefecht
- https://themanifest.com/company/hecht-ins-gefecht
- https://www.topseos.com/profile/hecht-ins-gefecht-digitalagentur-fur-webdesign-seo
- https://www.semfirms.com/profile/hecht-ins-gefecht
- https://www.omt.de/agentur-finden/agentur/hecht-ins-gefecht/
- https://onlinemarketing.de/dienstleister/online-marketing-agentur/bremen/hecht-ins-gefecht
- https://www.agenturtipp.de/agentur/hecht-ins-gefecht/
- https://www.seo-united.de/seo-agenturen/hecht-ins-gefecht-3461/
- https://omr.com/de/reviews/service/hecht-ins-gefecht
- https://www.ibusiness.de/dienstleister/jb/092582windolph.html
- https://feedbax.de/anbieter/hecht-ins-gefecht
- https://feedbax.ai/profile/hecht-ins-gefecht
- https://www.werbeagentur.de/de/a/hecht-ins-gefecht
- https://www.campixx.de/agenturen/seo/hecht-ins-gefecht/
- https://agenturfinder.com/agenturen/hecht-ins-gefecht/
- https://agencyvista.com/agency/hecht-ins-gefecht/marketing-agency/summary
- https://www.bark.com/de/de/company/hecht-ins-gefecht/NlYy2/
- https://www.provenexpert.com/de-de/hecht-ins-gefecht/
- https://de.trustpilot.com/review/hechtinsgefecht.de
- https://www.trustedshops.de/bewertung/hechtinsgefecht-de
- https://www.awwwards.com/HECHTINSGEFECHT/
- https://www.bremen.de/visitenkarte/digitalagentur-hecht-ins-gefecht---webdesign--seo-46684197
- https://www.yelp.com/biz/hecht-ins-gefecht-bremen
- https://maps.apple.com/place?place-id=IBAEFB4CEAFB63F7B
author: Benny Windolph
author_url: https://hechtinsgefecht.de/benny-windolph/
author_orcid: https://orcid.org/0009-0009-2458-3099
author_knowledge_graph_id: /g/11v4_sqnsh
---
# Crawl Budget und Cost of Retrieval: Was das Crawlen deiner Website kostet
Wenn Google auf einer großen Website oder einem Shop mit vielen URLs Seiten selten oder gar nicht crawlt, woran liegt das? Ich habe in über 30 Audits bei HECHT INS GEFECHT vor allem drei Ursachen gesehen. Es waren langsame Server-Antworten, URL-Massen ohne Wert und Sperren vor dem Server.
Bei einem Shopware-6-Shop bediente der HTTP-Cache nur Clients mit einem bestimmten Cookie, und der Googlebot bekam nie eine Cache-Antwort. Die Crawling-Statistiken zeigten [1.070 Millisekunden durchschnittliche Abrufzeit](#server-antwortzeit-ttfb), und mit Cookie antwortete der Server in 160 bis 290 Millisekunden. Bei einem internationalen Buchungsportal produzierte der KI-Trainings-Crawler von Meta [94.000 Abrufe auf fast 93.000 einzigartigen URLs](#crawl-budget-und-seitenanzahl), bei nur 613 echten Seiten. Und bei einem großen Fashion-Onlineshop beantwortete die Firewall [die Anfragen aller getesteten KI-Crawler mit dem Statuscode 403](#firewall-als-unsichtbarer-roadblock), obwohl die robots.txt sie erlaubte.
Den fachlichen Rahmen dazu habe ich im April 2025 in einem Gastbeitrag für die AFS Akademie veröffentlicht. Dort erkläre ich das Konzept Cost of Retrieval.
## Inhalt
1. [Was ist das Crawl Budget?](#was-ist-das-crawl-budget)
2. [Cost of Retrieval: Das Konzept hinter dem Begriff](#cost-of-retrieval-das-konzept-hinter-dem-begriff)
3. [Warum Cost of Retrieval 2026 so relevant ist](#warum-cost-of-retrieval-2026-so-relevant-ist)
4. [Die 5 Faktoren, die den Cost of Retrieval bestimmen](#die-5-faktoren-die-den-cost-of-retrieval-bestimmen)
5. [Cost of Retrieval für KI-Crawler: GPTBot, ClaudeBot und Co.](#cost-of-retrieval-fur-ki-crawler-gptbot-claudebot-und-co)
6. [Cost of Retrieval optimieren: Server, Datenbank, Seitenstruktur](#cost-of-retrieval-optimieren-server-datenbank-seitenstruktur)
7. [Cost of Retrieval messen: Tools und Methoden](#cost-of-retrieval-messen-tools-und-methoden)
8. [Cost of Retrieval in der Praxis: Keywordkönig-Wettbewerb](#cost-of-retrieval-in-der-praxis-keywordkonig-wettbewerb)
9. [Die Grenze: Wenn niedriger Cost of Retrieval nicht reicht](#die-grenze-wenn-niedriger-cost-of-retrieval-nicht-reicht)
10. [Häufige Fragen zu Cost of Retrieval](#haufige-fragen-zu-cost-of-retrieval)
11. [Quellen](#quellen)
## Was ist das Crawl Budget?
Das Crawl Budget ist die Menge an URLs, die Google auf deiner Website crawlen kann und will. Für jede Website hat Google nur begrenzt Zeit und Rechenleistung. Zwei Größen bestimmen das Crawl Budget: das Crawling-Kapazitätslimit und der Crawling-Bedarf.
Das Crawling-Kapazitätslimit, auch Hostlast genannt, berechnet Google selbst. Es begrenzt die Gesamtzeit, die dein Server Verbindungen für Google offen hält, und berücksichtigt Anzahl und Dauer paralleler Verbindungen sowie Googles eigene Ressourcen. Antwortet deine Website schnell und stabil, steigt das Limit. Wird sie langsamer oder kommen Serverfehler dazu, sinkt es und Google crawlt weniger.
Der Crawling-Bedarf beschreibt, wie wichtig Google deine URLs einschätzt. Beliebtheit und Aktualität deiner Inhalte erhöhen den Bedarf. Duplikate und unwichtige URLs verbrauchen dagegen Crawling-Zeit auf Seiten, die nie in den Index sollen.
Für wen ist das Crawl Budget relevant? Laut Google betrifft das vor allem große Websites mit über einer Million Seiten, deren Inhalt sich wöchentlich ändert. Relevant ist das Budget auch für mittelgroße Websites mit mehr als 10.000 Seiten und täglich wechselnden Inhalten. Das gilt ebenso für Websites, bei denen ein Großteil der URLs in der Search Console als „Gefunden, zurzeit nicht indexiert“ klassifiziert ist.
Wer wenige Seiten hat, die sich selten ändern, braucht sich um das Crawl Budget keine Gedanken zu machen.
Gecrawlt heißt nicht indexiert. Google kann eine URL abrufen und sie trotzdem nicht in den Index aufnehmen.
Cost of Retrieval ist ein Erklärmodell dafür, wie diese beiden Größen zusammenwirken. Wird deine Website langsamer oder liefert sie Serverfehler, senkt Google laut seiner Dokumentation das Kapazitätslimit und crawlt weniger. URL-Massen ohne Wert verbrauchen Crawling-Zeit auf Seiten, die nie in den Index sollen. Je mehr Zeit und Rechenleistung ein einzelner Abruf braucht, desto weniger Seiten kann Google in derselben Zeit abrufen. In [Crawl Budget und Seitenanzahl](#crawl-budget-und-seitenanzahl) stehen Fälle mit Abrufmengen und Fehlerquoten, in denen Google und KI-Crawler ihre Abrufe auf wertlose URLs verbrauchen.
## Cost of Retrieval: Das Konzept hinter dem Begriff
Im Modell steht Cost of Retrieval für den Rechenaufwand, den Google für das Abrufen und Verarbeiten einer Seite investiert. Der Begriff kommt aus dem Information Retrieval, einem Forschungsfeld, das sich mit der gezielten Extraktion von Informationen aus großen Datenmengen beschäftigt. Googlebot ist Googles Webcrawler, ein automatisiertes Programm, das Webseiten systematisch abruft und deren Inhalte für den Suchindex aufbereitet. Für SEO lautet die zentrale Frage letztlich: Lohnt sich der rechnerische Aufwand, Informationen aus einer Website zu extrahieren?
Auf der einen Seite steht die Rechenleistung, die Google investieren muss: Server-Anfragen, Rendering, Speicherung. Auf der anderen Seite steht der Informationsgehalt der Seite. Im Modell crawlt Google eine Seite eher, wenn ihr Informationswert höher ist.
Crawling und Indexierung sind trotzdem getrennte Stufen. Laut einer eidesstattlichen Erklärung von Googles Suchchefin (Januar 2026) wird gecrawlter Inhalt erst analysiert und annotiert, und nur eine Teilmenge kommt in den Index. Das Kostenmodell erklärt also vor allem, wie oft Google crawlt. Ob eine Seite in den Index kommt, ist eine eigene Auswahlentscheidung.
Google speichert die Informationen indexierter Seiten im Google-Index, einer großen Datenbank auf Tausenden Computern. Rechnest du mit der Obergrenze von 2 MB je Abruf, kämen bei 5.000 Produktseiten einer einzigen Domain bis zu 10 GB zusammen. Typische HTML-Seiten sind deutlich kleiner. Hochgerechnet auf das ganze Web erklärt das aus meiner Sicht, warum Google so selektiv crawlt.
Kosten-Nutzen-Abwägung im Modell Cost of Retrieval: Was Google investiert und was eine Seite liefern muss
Kosten-Nutzen-Abwägung
Was Google investieren muss
Kosten
Server-Anfragen senden und verarbeiten
JavaScript rendern (Headless Chrome)
Inhalte im Index speichern
5.000 Seiten × 2 MB (Obergrenze) = 10 GB
VS
Was die Seite liefern muss
Nutzen
Einzigartiger, relevanter Content
Neuer Informationsgehalt (Information Gain)
Klarer Nutzen für Suchende
Saubere Technik, schnelle Auslieferung
Aufwand > Nutzen → Google crawlt seltener
Nutzen > Aufwand → Google crawlt häufiger
Abb. 1 · HECHT INS GEFECHT
Abb. 1: Das Modell Cost of Retrieval, Rechenaufwand gegenüber Informationswert beim Crawlen
## Warum Cost of Retrieval 2026 so relevant ist
Jeden Tag gehen Tausende neue Websites online, viele davon mit KI-generierten Inhalten, die in ähnlicher Form schon existieren. Nach meiner Beobachtung filtert Google mittlerweile immer stärker und die Schwelle, ab der sich das Crawlen für Google lohnt, steigt seit 2024 kontinuierlich.
Modernes Retrieval läuft im Modell in Stufen ab: lexikalische Kandidaten-Generierung, semantisches Retrieval, Reranking, Synthese. Was ein System nicht abruft, kann keine dieser Stufen erreichen, bei Google wie bei [KI-Systemen](https://hechtinsgefecht.de/llm-sichtbarkeit/). Laut der [Crawl-Budget-Dokumentation](https://developers.google.com/crawling/docs/crawl-budget) sinkt das Limit, wenn eine Website langsamer wird, und Google crawlt dann weniger. Ausdrücklich nennt sie dabei Latenz und Time to First Byte.
Koray Tuğberk Gübür, Gründer von Holistic SEO Digital, hat Cost of Retrieval in der SEO bekannt gemacht. Für ihn ist Google zuerst ein Werbeunternehmen, wie er in seinem [Vortrag beim Kalicube Summit 2026](https://kalicubesummit.com/2026/sessions/koray-tugberk-gubur-cost-of-retrieval-session/) erklärt. Deshalb bevorzugt Google die Quelle, die das Nötige zu geringeren Kosten liefert. Nach meiner Einschätzung wird Cost of Retrieval oft übersehen, weil er in Keyword-Rankings nicht direkt sichtbar ist.
Dazu kommen die KI-Crawler. GPTBot, der Trainings-Crawler von OpenAI, hat seine Anfragen laut Cloudflare von Mai 2024 bis Mai 2025 um 305 % gesteigert. Nach meiner Einschätzung wägen auch diese Crawler Aufwand gegen Nutzen ab, nur mit härteren Regeln als Google.
## Die 5 Faktoren, die den Cost of Retrieval bestimmen
Fünf Faktoren bestimmen, wie teuer eine Seite für Google im Abruf ist: Server-Antwortzeit (TTFB), Seitengröße, Rendering-Aufwand, Crawl Budget und technische Roadblocks. Die folgenden Abschnitte zeigen für jeden Faktor konkrete Messwerte aus Kundenprojekten.
Die fünf Faktoren des Cost of Retrieval
5 Faktoren des Cost of Retrieval
1
Server-Antwortzeit (TTFB)
Faustregel: unter 400 ms. Über 600 ms
schlägt auch Lighthouse an.
2
Seitengröße und HTML-Komplexität
Googlebot liest höchstens 2 MB HTML.
Langes HTML kostet Rechenzeit.
3
Rendering-Aufwand (JavaScript)
JS-Rendering kostet extra.
Statisches HTML wird bevorzugt.
4
Crawl Budget und Seitenanzahl
Mehr Seiten = weniger Budget pro Seite.
Dünnen Content konsequent bereinigen.
5
Technische Roadblocks
429, robots.txt, noindex, Redirects,
Canonicals und 500er-Fehler.
Jeder Faktor erhöht den Aufwand für Google.
Abb. 2 · HECHT INS GEFECHT
Abb. 2: Die 5 Faktoren des Cost of Retrieval
### 1. Server-Antwortzeit (TTFB)
Time to First Byte (TTFB) misst die Zeitspanne zwischen der Anfrage des Crawlers und dem ersten empfangenen Byte der Server-Antwort. Feste Grenzwerte für das Crawling nennt Google nicht. Meine Faustregel: unter 200 Millisekunden sehr gut, 200 bis 400 realistisch, ab 600 wird es teuer. Darüber meldet auch Googles Prüfwerkzeug Lighthouse eine zu langsame Server-Antwort.
Bei einem E-Commerce-Kunden lag die durchschnittliche Server-Antwortzeit in den Crawling-Statistiken im März 2026 bei über 600 Millisekunden, obwohl Cloudflare vorgeschaltet war.
Bei einem anderen Kunden erreichten die Kategorieseiten im Februar 2026 rund 900 Millisekunden TTFB. Der Shopware-Entwickler vermutete als Ursache, dass jede Kategorieseite bei jedem Aufruf 48 Produkte plus einen Topseller-Slider lädt und der Produkt-Cache dabei nicht greift. In einem Test im Kundentermin waren die Kategorieseiten ohne warmen Cache um ein Mehrfaches langsamer als mit Cache.
Problematisch wird das nach meiner Erfahrung, weil Google nicht immer mit warmem Cache crawlt. Der Googlebot erfasst die langsame Version, wenn er eine Kategorieseite ohne Cache trifft. Dann fließt die langsame Antwort in die Antwortzeit ein, an der Google sein Crawling ausrichtet.
Ein Shopware-Shop mit vielen Produktvarianten zeigt die Größenordnung (Messung vom September 2026). Produktseiten brauchten kalt 1,3 bis 2,7 Sekunden, warm nur 0,07 bis 0,22 Sekunden. Bei den Varianten-URLs, die tatsächlich ranken, lag der letzte Crawl im Median 70 Tage zurück, und sie lagen praktisch nie im Cache. Dazu leerte jeder Inhalts-Push über die Admin-Schnittstelle den kompletten HTTP-Cache, auch die Pushes von HECHT INS GEFECHT.
Ein Shopware-6-Fall aus dem Sommer 2026 zeigt, was es kostet, wenn der Cache den Googlebot nicht bedient. Der HTTP-Cache der Website war aktiv und funktionierte, nur eben nie für den Googlebot. Shopware lieferte Cache-Treffer in dieser Konfiguration nur an Clients mit einem bestimmten Cookie aus. Der Googlebot sendete keine Cookies und traf deswegen bei jedem Abruf einen vollen PHP-Render.
Das Ergebnis in den Crawling-Statistiken der Search Console: durchschnittlich 1.070 Millisekunden Abrufzeit über alle Dateitypen. Mit Cookie antwortete derselbe Server in 160 bis 290 Millisekunden.
Ich habe Martin Splitt, Developer Advocate bei Google, im Oktober 2025 auf Mastodon direkt gefragt, wie sich der TTFB weiter senken lässt. Mein Setup war ein schlankes WordPress auf OpenLiteSpeed mit einem dedizierten Hetzner-Server. Ich hatte alles optimiert, was sich optimieren ließ, und kam trotzdem nicht unter 300 Millisekunden in der Google Search Console (GSC). Seine Antwort: „300ms is ja schon super. Bedenke, dass wir meistens aus den USA crawlen also könnte ein CDN da helfen, aber ich würd bei so einer niedrigen response time jetzt nicht zu viel drüber nachdenken.“
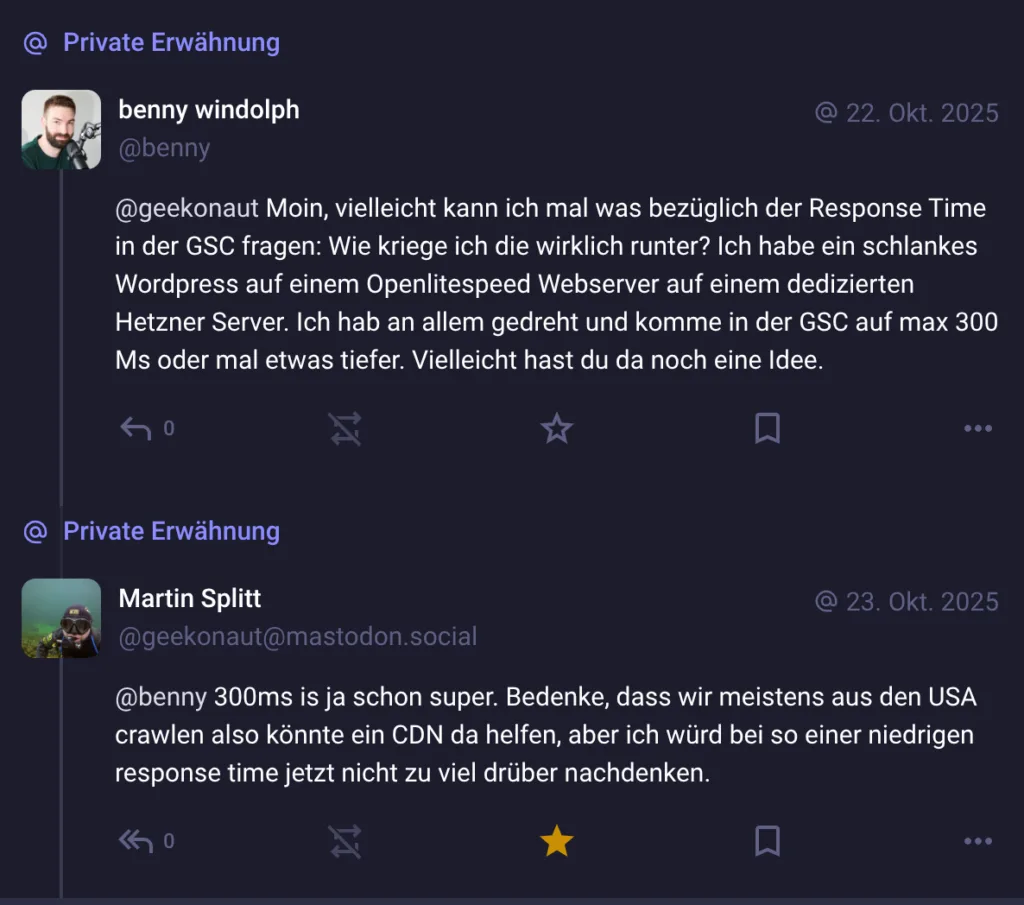
Splitt hält 300 Millisekunden also für einen sehr guten Wert. Google crawlt überwiegend aus den USA. Die physische Distanz zum Server kann sich deswegen auf den TTFB auswirken. Ein CDN wie Cloudflare kann hier helfen, bei Werten um 300 Millisekunden ist der Grenznutzen aber gering.
Der Shopware-6-Fall von oben zeigt, wie groß der Effekt werden kann. Lokal gemessen, also ohne den US-Umweg, aber ebenfalls ohne Cookie, antwortete der Server im Mittel über die Dateitypen in rund 356 Millisekunden. Die Crawling-Statistiken meldeten 1.070 Millisekunden. Einen großen Teil des Unterschieds erklärt vermutlich der Weg aus den USA, getrennt gemessen ist das nicht.
Ich empfehle, den TTFB unter 400 Millisekunden zu halten. Ab 600 Millisekunden wird es nach meiner Erfahrung teuer, weil Google bei langsamen Antworten weniger crawlt. Die durchschnittliche Antwortzeit zeigen die Crawling-Statistiken der Search Console unter Einstellungen, aufgeschlüsselt nach Dateityp; für die Seiten selbst wählst du den Dateityp HTML.
TTFB-Faustregel: Vier Zonen zur Bewertung der Server-Antwortzeit
TTFB-Faustregel: Antwortzeit bewerten
Exzellent
Sehr schnelle Antwortzeit.
< 200 ms
Gut
Akzeptabel für die meisten Websites.
200 bis 400 ms
Kritisch
Cost of Retrieval steigt.
400 bis 600 ms
Problem
Crawl-Frequenz sinkt. Sofort handeln.
> 600 ms
„
300ms is ja schon super. Bedenke, dass wir
meistens aus den USA crawlen …
Martin Splitt, Google Developer Advocate
Abb. 3 · HECHT INS GEFECHT
Abb. 3: TTFB-Faustregel aus meiner Praxis, Server-Antwortzeiten von exzellent bis Problem
### 2. Seitengröße und HTML-Komplexität
Seit Februar 2026 nennt die Googlebot-Doku 2 MB, davor nannte Google seit 2022 15 MB. Im März 2026 hat Google die Limits im Blog ausführlich erklärt.
Googlebot lädt bei einer HTML-Seite maximal die ersten 2 MB, inklusive HTTP-Header. Bei PDF-Dateien liegt die Grenze bei 64 MB. Alles oberhalb der 2 MB rendert Google nicht und indexiert es nicht.
Entscheidend ist, was bei einer Überschreitung passiert. Google kappt die Seite exakt bei 2 MB und verarbeitet dieses Fragment, als wäre es die komplette Datei. Liegen strukturierte Daten, das Canonical-Tag oder die Meta Description hinter der 2-MB-Marke, fehlen diese Elemente für Google vollständig. Das passiert etwa, wenn davor mehrere Megabyte Inline-CSS, Base64-Bildern oder ein sehr großes Menü sitzen.
Die Reihenfolge im HTML-Quelltext ist deswegen wichtig. Title, Canonical-Tag, Meta Description und strukturierte Daten gehören so weit nach oben wie möglich.
Ein weiteres Detail aus dem Blogpost: Sub-Ressourcen wie JavaScript- und CSS-Dateien haben jeweils ein eigenes 2-MB-Limit. Sie zählen nicht gegen die Größe der übergeordneten HTML-Seite. Ein JavaScript-Bundle mit 3 MB wird also ebenfalls bei 2 MB abgeschnitten, unabhängig davon, wie schlank die HTML-Seite selbst ist. Medien, Fonts und einige exotische Dateitypen werden vom Web Rendering Service gar nicht erst angefordert.
Bei einem Kunden lieferten die Bing Webmaster Tools den Hinweis „HTML zu lang“. Der Quelltext bestätigte den Hinweis: über 12.000 Zeilen HTML, rund dreimal so viele wie eine Seite bei Amazon mit rund 4.000 Zeilen. Ob die 2-MB-Grenze erreicht war, zeigen Zeilen allein nicht, aber jede Zeile kostet beim Abruf Zeit.
In meinen Audits sehe ich große Hero-Slider und eingebettete Videos, die Seiten auf bis zu 15 MB bringen. Bilder und Videos sind eigene Dateien und zählen nicht zum 2-MB-Limit der HTML-Datei; kritisch wird es, wenn Bilder als Base64 oder große Styles direkt im HTML stehen. Drei konkrete Maßnahmen: Slider entfernen, Videos extern einbetten, Bilder komprimieren. Und eine vierte: Kritische HTML-Elemente an den Anfang des Quelltexts verschieben, vor Menüs und vor Inline-Ressourcen.
### 3. Rendering-Aufwand und JavaScript-Abhängigkeit
Zwischen einem statischen Blog und einer JavaScript-lastigen Single Page Application liegt eine enorme Bandbreite im Cost of Retrieval. Google kann JavaScript rendern, aber das Rendering kostet Rechenzeit, und diese Rechenzeit fließt direkt in den Cost of Retrieval.
Bei einem Shopware-Kunden blockierte die robots.txt Teile des Widgets-Verzeichnisses. Die Startseite konnte deswegen beim Rendern nicht vollständig geladen werden. Google speicherte die Startseite ohne den eigentlichen Content. Die wichtigste Seite der Domain stand damit inhaltsleer im Index.
Solche Probleme entdeckst du zuverlässig, wenn du den gerenderten Output in der Google Search Console prüfst.
Im Juni 2026 habe ich bei einem großen Fashion-Onlineshop gesehen, was clientseitiges Rendering wirklich kostet. Der Shop nutzt ein Headless-Frontend, das die Seiten per JavaScript aus einer Schnittstelle zusammenbaut. Die Kategorieseiten lieferten serverseitig im Median 28 Wörter aus. Erst nach der JavaScript-Ausführung standen rund 700 Wörter im DOM (dem fertig aufgebauten Seiteninhalt im Browser).
Im statischen HTML fand sich statt des Produktgrids nur ein Lade-Spinner, und kein statischer Link auf Produktdetailseiten. Die interne Verlinkung in die Tiefe der Website hing damit an Googles zweitem Rendering-Schritt.
Die Folge stand in der Search Console: über 100.000 Seiten gecrawlt, aber nicht indexiert, überwiegend valide Produkte und Kategorien. Dass dieser zweite Schritt Zeit kostet, ist gemessen. Das zeigt eine [Onely-Auswertung](https://www.onely.com/blog/google-needs-9x-more-time-to-crawl-js-than-html/) aus dem Jahr 2022. Einem per JavaScript erzeugten Link folgte der Googlebot erst nach 52 Stunden, demselben Link im statischen HTML nach 25 Stunden.
Nach meiner Erfahrung ist die Lösung selten ein komplettes Server-Side-Rendering. Der Shop lud Produkte und Preise per JavaScript nach. Besser ist eine Aufteilung: statische Inhalte wie Text, Produktliste und Links serverseitig ausliefern, nur Preis- und Bestandsdaten dynamisch nachladen.
Google hat außerdem bestätigt, dass der Web Rendering Service (WRS) zustandslos arbeitet. Local Storage und Session-Daten werden zwischen Requests gelöscht. JavaScript, das auf gespeicherte Session-Daten angewiesen ist, um Content auszugeben, produziert im WRS leere Seiten.
Auch hier gilt das 2-MB-Limit. Der WRS kann nur den Code ausführen, den der Crawler tatsächlich abgerufen hat. Wird ein JavaScript-Bundle bei 2 MB abgeschnitten, fehlt dem WRS der Rest des Codes.
Ein weiteres Cost-of-Retrieval-Problem bei JavaScript betrifft Text, der auf dem Handy erst nach einem Klick auf „Mehr erfahren“ nachgeladen wird. Diesen Text sieht Google nicht, weil Google Search nicht mit der Seite interagiert. Steht der Text dagegen schon im HTML und ist nur eingeklappt, etwa in einem Akkordeon oder Tab, ist das laut Google in Ordnung. Voraussetzung ist, dass er dem Desktop-Inhalt entspricht, denn Google indexiert die mobile Version (Mobile-First-Indexierung).
**Pro-Tipp:** Vermeide interne Verlinkung per JavaScript. Google kann Links crawlen, die JavaScript als normales `` in die Seite einfügt. KI-Crawler wie GPTBot führen aber kein JavaScript aus. Klassische ``-Links im ausgelieferten HTML sind deswegen die sichere Variante.
### 4. Crawl Budget und Seitenanzahl
Crawl Budget beschreibt die Anzahl der Seiten, die Google auf einer Domain in einem bestimmten Zeitraum crawlt. Je mehr Seiten existieren, desto stärker verteilt Google das Crawl Budget, und desto weniger Aufmerksamkeit erhält jede einzelne Seite. Ein hoher Cost of Retrieval auf vielen Seiten erschöpft das Crawl Budget schneller.
Bei einem Shopware-Kunden zeigte die Google Search Console ein Indexierungsverhältnis von 4:1. Etwa 2.800 URLs waren nicht indexiert, während nur rund 700 URLs im Index standen. Google verschwendete einen Großteil des Crawl Budgets für Seiten, die am Ende nicht indexiert wurden: 404-Fehler, 500er-Fehler, Duplikate.
Crawl-Budget-Verschwendung: Vier von fünf gecrawlten URLs landen nicht im Index
Crawl-Budget-Verschwendung
Indexierungsverhältnis eines E-Commerce-Kunden (Shopware)
Nicht indexiert
2.800
Indexiert
700
4 : 1
Vier von fünf gecrawlten URLs landen nicht im Index.
Ursachen der Verschwendung
404-Fehler und 500er-Fehler auf der Domain
Duplikate und Seiten ohne eigenen Mehrwert
Nicht indexierte URLs kosten Budget ohne Gegenwert.
Abb. 4 · HECHT INS GEFECHT
Abb. 4: Crawl-Budget-Verschwendung, Indexierungsverhältnis 4:1
Derselbe Fashion-Onlineshop aus dem Rendering-Abschnitt zeigte, wie das Muster nach oben skalierte. Im GSC-Domain-Property lag das Verhältnis von nicht indexierten zu indexierten URLs bei rund 5:1, allein über 340.000 URLs antworteten mit 404. Dazu kamen 17 Länder-Shops mit nahezu identischem Sortiment und 18 Sitemaps mit je rund 10.000 URLs. Nach meiner Einschätzung musste Google ohne hreflang (das Signal für Sprach- und Länderversionen) im ausgelieferten HTML viele fast gleiche Seitenbäume crawlen.
Noch drastischer war ein internationales Buchungsportal. Dort hängte der Login-Link an jede URL einen Login-Parameter an, auch an URLs, die den Parameter bereits trugen. Jede gecrawlte Variante verlinkte so auf eine noch längere Variante, eine klassische Spider-Trap (eine Linkstruktur, die Crawler in endlose URL-Varianten schickt).
Der KI-Trainings-Crawler von Meta produzierte dort rund 94.000 Abrufe auf fast 93.000 einzigartigen URLs, bei nur 613 echten Seiten. 99,3 Prozent des Crawls waren Duplikate. Das Canonical zeigte korrekt auf die saubere URL und begrenzte den Schaden im Index. Der Server lieferte dafür trotzdem rund 4,7 GB aus, in etwa drei Tagen.
Die GSC-Crawling-Statistiken desselben Portals zeigten zudem, dass nur 47 Prozent der Googlebot-Anfragen mit Status 200 endeten. 19 Prozent liefen in 404-Fehler, 17 Prozent in Weiterleitungen. Der Hoststatus stand auf Grün und der Server hätte mehr verkraftet. Die Kapazität reichte also, begrenzt hat der Crawling-Bedarf.
Bei einem anderen Kunden hat HECHT INS GEFECHT die nicht indexierten Seiten Schritt für Schritt bereinigt. Danach stieg nach meiner Beobachtung die Crawl-Frequenz der relevanten Seiten.
Wie hart diese Regel bei fehlender Autorität greift, habe ich im SEO-Contest 2026 erlebt. Eine Methoden-Unterseite mit stark überlappendem Content zur Homepage-Sektion stand auf der brandneuen Domain trotz ultraschlanker Technik auf „Gecrawlt, zurzeit nicht indexiert“. Nach sechs Tagen habe ich sie per 301 auf die Startseite umgeleitet und die Sitemap von vier auf drei URLs reduziert.
Der Fall zeigt aus meiner Sicht, dass niedriger Cost of Retrieval allein nicht reicht, wenn der [Information Gain](https://hechtinsgefecht.de/information-gain/) fehlt. Der Beitrag zur [Google Sandbox](https://hechtinsgefecht.de/google-sandbox/) erzählt den kompletten Contest-Fall.
**Faustregel:** Jede Seite ohne echten Mehrwert verschwendet Crawl Budget. Lösche solche Seiten mit 404 oder 410, oder sperre sie per robots.txt für das Crawling. Ein noindex spart laut Google keine Crawling-Zeit, weil Google die Seite trotzdem abruft. Besonders nach einem [Website-Relaunch](https://hechtinsgefecht.de/website-relaunch-seo/) häufen sich 404-Fehler und URL-Duplikate, die das Crawl Budget belasten und die du direkt im Audit-Prozess mitbereinigen solltest.
### 5. Technische Roadblocks, die das Crawling verhindern
Neben den Performance-Faktoren existieren technische Fehler, die den Cost of Retrieval unendlich hoch treiben, weil sie Crawling oder Indexierung blockieren:
- **429 Too Many Requests:** Bei einem Kunden trat dieser Statuscode auf, als Semrush einen Backlink-Check durchführte. Der Server war überlastet. Google wertet 429 als Serverfehler und crawlt den Host vorübergehend langsamer. Antwortet der Server wieder normal, steigt die Crawl-Rate schrittweise; bleiben 429-Fehler dauerhaft, entfernt Google bereits indexierte URLs.
- **Fehlerhaft konfigurierte robots.txt:** Der Crawler erhält versehentlich keinen Zugriff auf indexierungsrelevante Inhalte.
- **Falsche Robots-Meta-Tags:** noindex oder nofollow an Stellen, wo keines sein sollte. Ein noindex wirkt nur auf die Indexierung; gecrawlt wird die Seite trotzdem. Google crawlte bei einem Kunden sogar Staging-Umgebungen trotz noindex. Wer Inhalte vor dem Crawler schützen will, braucht HTTP-Auth oder eine IP-Sperre.
- **Weiterleitungsschleifen:** Der Crawler folgt den Weiterleitungen, bis er abbricht.
- **Falsche Canonical-Tags:** Google indexiert die falsche URL-Version, oder gar keine.
- **500er-Fehler:** Interne Serverprobleme verhindern den Zugriff komplett.
- **robots.txt-Wildcards, die nicht greifen:** Ein Muster wie Disallow: /\*?parameter\* blockiert nur URLs, bei denen der Parameter direkt hinter dem Fragezeichen steht. Steht er mit &-Verkettung weiter hinten in der URL, greift die Regel nicht. Beim erwähnten Buchungsportal crawlte selbst der regelkonforme Bingbot über 2.800 solcher URLs, weil die Regel sie nicht erfasste. Abhilfe schaffen zusätzliche Disallow-Regeln für die &-Varianten.
- **Relative Pfade ohne führenden Slash:** Links auf der ganzen Website wie images/logo.png statt /images/logo.png werden unter Sprach- oder Kampagnenpfaden immer neu aufgelöst und erzeugen viele 404-Fehler. Bei einem Kunden produzierte ein einziges relativ verlinktes Theme-Bild 175 Fehlerabrufe unter 50 Pfadvarianten, 3,6 Prozent des gesamten Googlebot-Traffics.
- **Firewalls und Bot-Protection:** Web Application Firewalls und Bot-Schutz am CDN blocken Crawler, unabhängig von der robots.txt. Der Statuscode-Check sieht sauber aus, solange du ihn nicht mit der richtigen Bot-Kennung fährst.
## Cost of Retrieval für KI-Crawler: GPTBot, ClaudeBot und Co.
Neben dem Googlebot crawlt eine ganze Reihe weiterer Bots das Web. Dazu gehören GPTBot und OAI-SearchBot für OpenAI, ClaudeBot für Anthropic, PerplexityBot sowie die Trainings-Crawler von Meta und anderen. Für alle gilt nach meiner Einschätzung dasselbe Kosten-Nutzen-Prinzip, mit weniger Spielraum als bei Google. Die großen KI-Crawler rendern kein JavaScript, und bei Live-Abrufen sind frühe Abbrüche beobachtet.
KI-Sichtbarkeit entsteht dabei auf drei Abruf-Ebenen. [Cloudflare](https://blog.cloudflare.com/crawlers-click-ai-bots-training/) weist den KI-Bot-Traffic nach Zweck aus. In den zwölf Monaten bis Juli 2025 dienten 80 Prozent des KI-Crawlings dem Training, 18 Prozent der Suche und 2 Prozent Nutzeraktionen wie Live-Abrufen.
Jede Ebene nutzt eigene Crawler mit eigenen Hürden. Die Suchindizes dahinter gehören oft nicht Google. ChatGPT sucht laut OpenAI über externe Suchdienste und Inhalte direkter Partner, die Claude-Websuche laut einer Google-Cloud-Doku über Brave Search.
### KI-Crawler rendern kein JavaScript
Der wichtigste Unterschied zu Google liegt im Rendering. Keiner der großen KI-Crawler von OpenAI, Anthropic oder Perplexity führt JavaScript aus. Vercel und MERJ haben im Dezember 2024 den KI-Crawler-Traffic im Vercel-Netzwerk ausgewertet, fast eine Milliarde Abrufe pro Monat.
GPTBot und ClaudeBot laden JavaScript-Dateien zwar herunter, führen sie aber nicht aus. Was erst nach dem Rendering im DOM steht, sehen diese Crawler nicht.
Der Fashion-Onlineshop von oben, mit im Median 28 Wörtern im statischen HTML, ist für Google deswegen ein Rendering-Kostenproblem. Für ChatGPT und Perplexity ist er eine fast leere Seite.
### Antwortzeit beim Live-Abruf
Auf der dritten Ebene, dem Live-Abruf, wird der TTFB noch wichtiger. Der Web-Performance-Experte [Max Böhme](https://www.maxboehme.net/performance-strategie/ai-crawler-server-antwortzeit/) hat Beobachtungen zu solchen Abbrüchen gesammelt. Eine Serverlog-Analyse und ein Konferenzvortrag sahen Abbrüche schon ab etwa 500 bis 800 Millisekunden, im nginx-Log als Status 499. Ein offizieller Grenzwert ist das nicht.
Der Googlebot passt bei langsamen Antworten seine Crawl-Rate an. Der Live-Abruf dagegen passiert in Echtzeit, während die Antwort entsteht. Die KI-Antwort wird dann ohne deine Website geschrieben.
Wie fehleranfällig der Live-Abruf im Extremfall sein kann, habe ich beim [ChatGPT-Crawler-Bug](https://hechtinsgefecht.de/chatgpt-crawler-bug/) dokumentiert. Vom 2. bis 10. Juni 2026 scheiterten alle 634 Live-Abrufe von ChatGPT auf der Domain von HECHT INS GEFECHT (im Log als 404). Ursache war ein HTTP/2-Fehler im Client von OpenAI. Kein Monitoring schlug Alarm.
### Die Firewall als unsichtbarer Roadblock
Den Extremfall auf der Gegenseite habe ich im Juni 2026 bei demselben Fashion-Onlineshop analysiert. Dessen Web Application Firewall (eine Schutzschicht vor dem Webserver, die Anfragen filtert) beantwortete die Anfragen aller getesteten KI-Crawler mit dem Statuscode 403. Die robots.txt erlaubte diese Crawler. Wer nur die Crawl-Steuerung prüft, findet nichts.
Der Block sitzt eine Ebene tiefer und filtert zweistufig. Bekannte Bot-Kennungen lehnt die Firewall direkt ab. Wer wie ein Browser aussieht, aber kein JavaScript ausführt, bekommt eine JavaScript-Challenge.
Datieren ließ sich die Sperre ohne jeden Zugriff auf Server-Logs. Die Wayback Machine erfasste den Shop 2025 an 246 Tagen mindestens einmal erfolgreich, 2026 nur noch an 43 Tagen. Die letzte erfolgreiche Erfassung war am 10. Mai 2026. Danach kamen nur noch 307 oder 403.
Der [Common Crawl](https://hechtinsgefecht.de/harmonic-centrality/) (das öffentliche Webarchiv, aus dem viele KI-Trainingsdaten stammen) bekam für den Shop im Mai und Juni 2026 nur noch 403. Beide Archive legen den Bruch auf den Mai 2026.
Auch das Ergebnis ist messbar. In einem Abzug mit 31 Fragen an zwölf KI-Systeme stand die technisch saubere, serverseitig gerenderte Unternehmenswebsite 62-mal in den Quellen, der Shop 32-mal. Dabei war die Sperre eine nachvollziehbare Entscheidung nach einer Überlastung durch Bots. Meine Empfehlung: gewünschte KI-Crawler gezielt über User-Agent und die offiziellen IP-Bereiche der Anbieter durchlassen.
### robots.txt und llms.txt steuern weniger, als du denkst
Die robots.txt wirkt bei KI-Systemen nur einseitig. Die regelkonformen Index- und Trainings-Crawler wie GPTBot respektieren sie. Bei den Live-Fetchern gilt das nicht durchgehend.
Laut OpenAI-Doku gilt die robots.txt für ChatGPT-User nicht unbedingt, weil Nutzer diese Abrufe auslösen. Laut Fachpresse steht das seit Dezember 2025 so in der Doku. Metas Fetcher darf sie laut eigener Dokumentation umgehen.
Und beim Buchungsportal von oben crawlte der KI-Trainings-Crawler von Meta über 84.000 per Wildcard-Disallow gesperrte URLs, obwohl Meta ihn über die robots.txt steuerbar nennt. Wer seinen Server gegen KI-Bots schützen muss, braucht deswegen Rate-Limits am Server oder an der Edge (den CDN-Servern vor dem eigenen Server).
Und die llms.txt? Die Idee dahinter: eine kuratierte Inhaltsliste für KI-Systeme im Root der Website.
Keiner der großen KI-Anbieter hat bestätigt, dass seine Crawler die Datei lesen. Google nutzt sie für die Suche nach eigener Doku nicht. Eine Logfile-Auswertung von EZY Research (Juli 2026, 83 Websites) zählte bei OpenAIs Crawlern 3.990 Abrufe der robots.txt und 7 der llms.txt. Die Datei schadet nach meiner Einschätzung nicht, einen messbaren Effekt sehe ich aber auch nicht.
## Cost of Retrieval optimieren: Server, Datenbank, Seitenstruktur
Cost of Retrieval lässt sich auf drei Ebenen senken: am Server, an der Datenbank und an der Seitenstruktur. Die größten Gewinne liegen erfahrungsgemäß beim Hosting, denn dort entsteht ein großer Teil des TTFB.
Drei Ebenen der Optimierung: Server, Datenbank, Seitenstruktur
Drei Ebenen der Optimierung
1
Server und Hosting
OpenLiteSpeed statt Apache einsetzen
HTTP/2 für den Googlebot aktivieren
DNS optimieren (Cloudflare)
2
Datenbank
Revisionen, Transients und Spam bereinigen
Log-Tabellen regelmäßig prüfen
Indexierung und Caching sicherstellen
3
Seitenstruktur
Statisches HTML statt JavaScript-Rendering
Kein Lazy-Load-Text hinter Overlays
Interne Links als klassische
Jede Ebene kann den Cost of Retrieval senken.
Abb. 5 · HECHT INS GEFECHT
Abb. 5: Drei Ebenen der Cost-of-Retrieval-Optimierung
### Server und Hosting optimieren
Shared Hosting reicht für Business-Websites und Webshops in der Regel nicht aus. Dort teilen sich viele Websites Rechenleistung und Arbeitsspeicher. Belastet eine davon den Server, können die Antwortzeiten der anderen steigen. Ein eigener Server (physisch oder Cloud) bietet mehr Performance und ermöglicht gezielte Optimierungen.
Drei konkrete Maßnahmen für niedrigeren Cost of Retrieval auf Server-Ebene:
- **Schneller Webserver:** OpenLiteSpeed statt Apache einsetzen.
- **HTTP/2 aktivieren:** Googles Crawler crawlen über HTTP/1.1 und HTTP/2. HTTP/2 spart laut Google Rechenressourcen bei der Website und beim Googlebot. HTTP/3 nennt Google für seine Crawler nicht.
- **DNS optimieren:** Cloudflare lag im Oktober 2026 im DNSPerf-Ranking weltweit auf Platz 5 von 84 und ist im Gratis-Tarif enthalten. Eine schnelle DNS-Auflösung verkürzt den TTFB.
### Datenbank schlank halten
Viele CMS und Shopsysteme basieren auf relationalen Datenbanken, die du regelmäßig optimieren solltest. Eine große, nie bereinigte Datenbank ohne Indexierung und Caching verlängert die Zugriffszeiten bei jedem einzelnen Seitenaufruf. Das erhöht den TTFB und den Cost of Retrieval. Bei WordPress erledigen Plugins wie WP-Optimize die Bereinigung automatisiert.
### Seitenstruktur statisch aufbauen
Baue Seiten so statisch wie möglich. Komplexe Effekte, die per JavaScript statt per CSS laufen, treiben den Cost of Retrieval beim Rendering hoch. Als Faustregel gilt: Wenn die Seite auch ohne JavaScript funktioniert, kann Google sie effizient crawlen.
## Cost of Retrieval messen: Tools und Methoden
Fünf kostenlose Wege zeigen den Cost of Retrieval: Die Google Search Console, die Bing Webmaster Tools, der site:-Befehl, Crawling-Tools und der Quelltext-Check.
Google Search Console: Unter Einstellungen zeigen die Crawling-Statistiken die durchschnittliche Antwortzeit über alle abgerufenen Ressourcen, aufschlüsselbar nach Dateityp, und die Zahl der Crawling-Anfragen. Crawlt der Googlebot selten, spricht das eher für einen hohen Cost of Retrieval.
Vorsicht bei Server-Logs hinter einem CDN. Dienste wie Cloudflare beantworten einen Großteil der Googlebot-Anfragen direkt an der Edge. Das eigene Log sieht diese Abrufe nie.
Beim Buchungsportal von oben zählte das Server-Log rund 470 Googlebot-Abrufe pro Tag. Die GSC-Crawling-Statistiken meldeten 4.700. Hinter einem CDN taugt fürs Googlebot-Volumen nur die GSC.
Wer Logs auswertet, sollte die IP-Adressen verifizieren. Bei einem Shopware-Kunden bestanden 27 % aller Anfragen mit Googlebot-Kennung den IP-Check nicht. Der größte Einzelposten war eine Adresse, die sich als Googlebot ausgab.
Bing Webmaster Tools: Die Bing Webmaster Tools werden oft unterschätzt. Sie geben Hinweise wie „HTML zu lang“ aus, die Google nicht explizit meldet.
site:-Befehl: site:domain.org in der Google-Suche zeigt indexierte Seiten der Domain, laut Google aber nicht unbedingt alle. Passt die Zahl der indexierten Seiten zur erwarteten Seitenanzahl? Tauchen ungewollte Dateien wie PDFs im Index auf?
Crawling-Tools: Screaming Frog, Ahrefs oder Semrush für einen vollständigen Crawl. Screaming Frog crawlt kostenlos bis zu 500 URLs. Wie du URLs danach gezielt zur Indexierung in Suchmaschinen und LLMs einreichst, zeigt der Artikel zur [Indexierung und LLM-Sichtbarkeit](https://hechtinsgefecht.de/indexierung-llm-sichtbarkeit/).
Vorsicht bei Speed-Tools: GTmetrix meldete im September 2026 für eine Produktseite eine Antwortzeit von 78 bis 110 ms, weil der Lighthouse-Vorlauf den Cache gefüllt hatte. Derselbe Abruf kalt per curl dauerte 1,3 bis 1,5 Sekunden. Die Antwortzeit beim ersten, ungecachten Abruf misst du deshalb mit curl auf frischen URLs. Felddaten aus dem Chrome UX Report (CrUX) zeigen ergänzend, was echte Nutzer erleben.
Quelltext-Check: Ein direkter Blick in den HTML-Code lohnt sich. Falsch gesetzte Robots-Meta-Tags oder fehlerhafte Canonical-Tags siehst du im Quelltext sofort.
## Cost of Retrieval in der Praxis: Keywordkönig-Wettbewerb
Beim Wettbewerb um das Keyword „Keywordkönig“ war Cost of Retrieval aus meiner Sicht einer von drei Hebeln. HECHT INS GEFECHT erreichte dort Platz 3 bei Google und gewann den Preis für die höchste KI-Sichtbarkeit beim Agenturtipp SEO-Contest 2025 (Messung: Rankscale).
Cost of Retrieval war der erste Hebel: eine technisch schnelle, leicht abrufbare Website. Die Seite lief ohne schweres CMS, mit schlankem HTML, schnellem Server und wenig JavaScript. Google konnte die Seite effizient crawlen und indexieren.
Information Gain bezeichnet den messbaren Mehrwert, den ein Text gegenüber bereits indexierten Inhalten zum selben Thema liefert. Nach diesem Modell sinkt der Cost of Retrieval für Google, je höher der Information Gain ist. Die anderen beiden Hebel waren Information Gain durch [semantisch optimierten Content](https://hechtinsgefecht.de/semantisches-seo/) und [Brand SEO](https://hechtinsgefecht.de/brand-seo/). Nach meiner Einschätzung konnten sie nur wirken, weil die technische Basis stimmte.
## Die Grenze: Wenn niedriger Cost of Retrieval nicht reicht
Niedriger Cost of Retrieval bringt eine Seite nicht automatisch in den Index. Das zeigt die Methoden-Unterseite aus dem SEO-Contest 2026 weiter oben: schlanke Technik, günstiger Abruf, trotzdem „Gecrawlt, zurzeit nicht indexiert“. Ihr Inhalt überschnitt sich stark mit der Startseite. Nach sechs Tagen habe ich die Unterseite per 301 auf die Startseite umgeleitet.
Wenn Seiten trotz regelmäßigem Crawling nicht in den Index kommen, fehlt nach meiner Erfahrung meist der Information Gain. Die Seiten liefern dann nichts, was der Index nicht schon hat.
Deswegen gehört zu jeder Cost-of-Retrieval-Optimierung die Frage, ob alle diese Seiten existieren müssen. Weniger, dafür dichtere Seiten senken den Crawl-Aufwand und heben den Informationswert. Technik-Fixes allein lösen den Status „Gecrawlt, zurzeit nicht indexiert“ nicht.
## Häufige Fragen zu Cost of Retrieval
### Was genau ist Cost of Retrieval im SEO?
Cost of Retrieval ist ein Erklärmodell. Es beschreibt das Verhältnis zwischen dem Aufwand für das Abrufen, Verstehen und Indexieren einer Seite und ihrem Informationswert. Nach diesem Modell crawlt Google eine Seite seltener, wenn der Aufwand den Nutzen überwiegt.
### Warum sind nicht alle meine Seiten bei Google indexiert?
Nicht alle Seiten einer Website werden indexiert. Oft genügen die Seiten den qualitativen Ansprüchen von Google nicht, oder technische Probleme verhindern Crawling und Indexierung. In meinen Audits sehe ich vor allem drei Ursachen: zu hohe Server-Antwortzeit (TTFB), Seiten ohne Mehrwert und technische Fehler wie 404er oder falsche Canonicals. Die Google Search Console zeigt unter "Seiten" den genauen Indexierungsstatus jeder URL.
### Welcher TTFB-Wert ist gut für SEO?
Google nennt für das Crawling keine festen Grenzwerte und führt die Time to First Byte in der Crawl-Budget-Doku nur als Faktor. Nach meiner Faustregel sind Werte unter 200 Millisekunden sehr gut, 200 bis 400 Millisekunden realistisch, ab 600 Millisekunden wird es teuer. Darüber meldet auch Googles Prüfwerkzeug Lighthouse eine zu langsame Server-Antwort. Werte über 900 Millisekunden habe ich bei mehreren E-Commerce-Kunden gemessen.
### Wie hängen Cost of Retrieval und Crawl Budget zusammen?
Der Cost of Retrieval ist ein Modell dafür, wie effizient Google das Crawl Budget einer Domain nutzen kann. Hoher Cost of Retrieval bedeutet, dass Google mehr Ressourcen pro Seite verbraucht und insgesamt weniger Seiten crawlt. Niedriger Cost of Retrieval bedeutet, dass Google mehr Seiten in derselben Zeit crawlt. Ob gecrawlte Seiten in den Index kommen, entscheidet Google getrennt davon.
### Beeinflusst Cost of Retrieval die Sichtbarkeit in KI-Systemen?
Aus meiner Sicht beeinflusst der Cost of Retrieval die Sichtbarkeit in KI-Systemen direkt, weil sie Inhalte über Trainingsdaten, Suchindizes und Live-Abrufe beziehen. ChatGPT sucht laut OpenAI über externe Suchdienste und Inhalte direkter Partner, Claude laut einer Google-Cloud-Doku über Brave Search. Die Crawler von OpenAI, Anthropic und Perplexity führten laut Vercel und MERJ (Dezember 2024) kein JavaScript aus und sahen clientseitige Inhalte nicht. Beobachtungen zeigen beim Live-Abruf Abbrüche schon ab etwa 500 bis 800 Millisekunden, ohne dass es einen offiziellen Grenzwert gibt.
### Warum crawlt Google meine Website nicht?
Wenn Google eine Website kaum oder gar nicht crawlt, sehe ich in meinen Audits vor allem drei Ursachen. Häufig sind es technische Blockaden wie robots.txt-Fehler, Firewall-Sperren oder Serverfehler. Oder langsame Antworten treiben den Cost of Retrieval hoch, oder der Crawling-Bedarf fehlt, weil Google die URLs für wenig gefragt oder selten geändert hält. Welcher Fall vorliegt, zeigen die Crawling-Statistiken der Google Search Console: Hoststatus und Antwortzeit für Technik und Performance, die Crawl-Frequenz für den Bedarf.
### Rendern KI-Crawler wie GPTBot JavaScript?
Nein. Laut einer Auswertung von Vercel und MERJ (Dezember 2024) führten die Crawler von ChatGPT, Claude und Perplexity kein JavaScript aus. Inhalte, die erst clientseitig entstehen, sahen sie deshalb nicht. Rendern können der Bingbot, der Applebot und mit Verzögerung der Googlebot, über den auch Gemini abruft.
## Quellen
- Illyes, Gary (2026): [„Inside Googlebot: demystifying crawling, fetching, and the bytes we process“](https://developers.google.com/search/blog/2026/03/crawler-blog-post), Google Search Central Blog. Offizielle Byte-Limits: 2 MB HTML, 64 MB PDF, WRS-Statelessness, Partial Fetching
- Windolph, Benny (2025): [„Cost of Retrieval: Warum Google manche Seiten nicht crawlt oder indexiert“](https://www.afs-akademie.org/magazin/cost-of-retrieval/), AFS Akademie
- Kalicube Summit (2026): [„Koray Tuğberk Gübür on Cost of Retrieval and the Algorithmic Trinity“](https://kalicubesummit.com/2026/sessions/koray-tugberk-gubur-cost-of-retrieval-session/). Session-Zusammenfassung: Cost of Retrieval als kommerzielle Logik, Ursprung bei Trystan Upstill
- Splitt, Martin (2025): Mastodon-Konversation zu TTFB und Googlebot-Crawling aus den USA, Google Developer Advocate
- Google: [„Crawl Budget Management“](https://developers.google.com/crawling/docs/crawl-budget), Google Crawling Infrastructure. Kapazitätslimit inklusive Latenz und Time to First Byte, noindex spart keine Crawling-Zeit
- Google: [„Google Crawler (User Agent) Overview“](https://developers.google.com/crawling/docs/crawlers-fetchers/overview-google-crawlers), Google Crawling Infrastructure. HTTP/1.1 und HTTP/2, Ressourcen sparen mit HTTP/2
- Chrome for Developers: [„Reduce server response times“](https://developer.chrome.com/docs/lighthouse/performance/server-response-time), Lighthouse-Doku. Audit schlägt bei über 600 ms Server-Antwortzeit an
- Google: [„How Google Search works“](https://developers.google.com/search/docs/fundamentals/how-search-works), Google Search Central. Crawling, Indexing, Serving Pipeline
- Screaming Frog: [„SEO Spider“](https://www.screamingfrog.co.uk/seo-spider/). Crawl-Analyse-Methodik
- Vercel und MERJ (2024): [„The Rise of the AI Crawler“](https://vercel.com/blog/the-rise-of-the-ai-crawler), Vercel. Auswertung von knapp einer Milliarde KI-Crawler-Abrufen pro Monat: KI-Crawler führen kein JavaScript aus
- Cloudflare (2025): [„From Googlebot to GPTBot: Who’s Crawling Your Site“](https://blog.cloudflare.com/from-googlebot-to-gptbot-whos-crawling-your-site-in-2025/), Cloudflare. Wachstum und Marktanteile der KI-Crawler (GPTBot +305 %)
- Cloudflare (2025): [„The crawl-to-click gap: Cloudflare data on AI bots, training, and referrals“](https://blog.cloudflare.com/crawlers-click-ai-bots-training/), Cloudflare. Zweck des KI-Crawlings in den zwölf Monaten bis Juli 2025: 80 % Training, 18 % Suche, 2 % Nutzeraktionen
- Böhme, Max (2026): [„Warum ChatGPT deine Seite ignoriert: Server-Antwortzeiten für AI-Crawler messen“](https://www.maxboehme.net/performance-strategie/ai-crawler-server-antwortzeit/). Beobachtete Abbrüche von ChatGPT-User ab etwa 500 bis 800 ms
- Google: [„Google’s Guide to Optimizing for Generative AI Features on Google Search“](https://developers.google.com/search/docs/fundamentals/ai-optimization-guide), Google Search Central. Keine KI-Textdateien für die Google-Suche nötig
- EZY Research (2026): [„We Put llms.txt on 83 Websites. OpenAI Read It 7 Times.“](https://www.ezy.ai/research/do-ai-bots-read-llms-txt). Logfile-Auswertung zu Abrufen der llms.txt