
„Eine neue Domain rankt die ersten sechs bis zwölf Monate nicht. Das ist die Google Sandbox.“ Den Satz höre ich regelmäßig, und ich halte ihn für eine Ausrede. Im Juni 2026 habe ich eine Domain auf ein Wort registriert, das es vorher nicht gab. 21 Tage später gewann sie den SEO-Contest 2026 gegen rund 200 Teilnehmer. Bei der Ahrefs-Messung Mitte Juni 2026 lag ihr Domain Rating, der Ahrefs-Wert für die Stärke des Backlinkprofils auf einer Skala bis 100, bei 0.
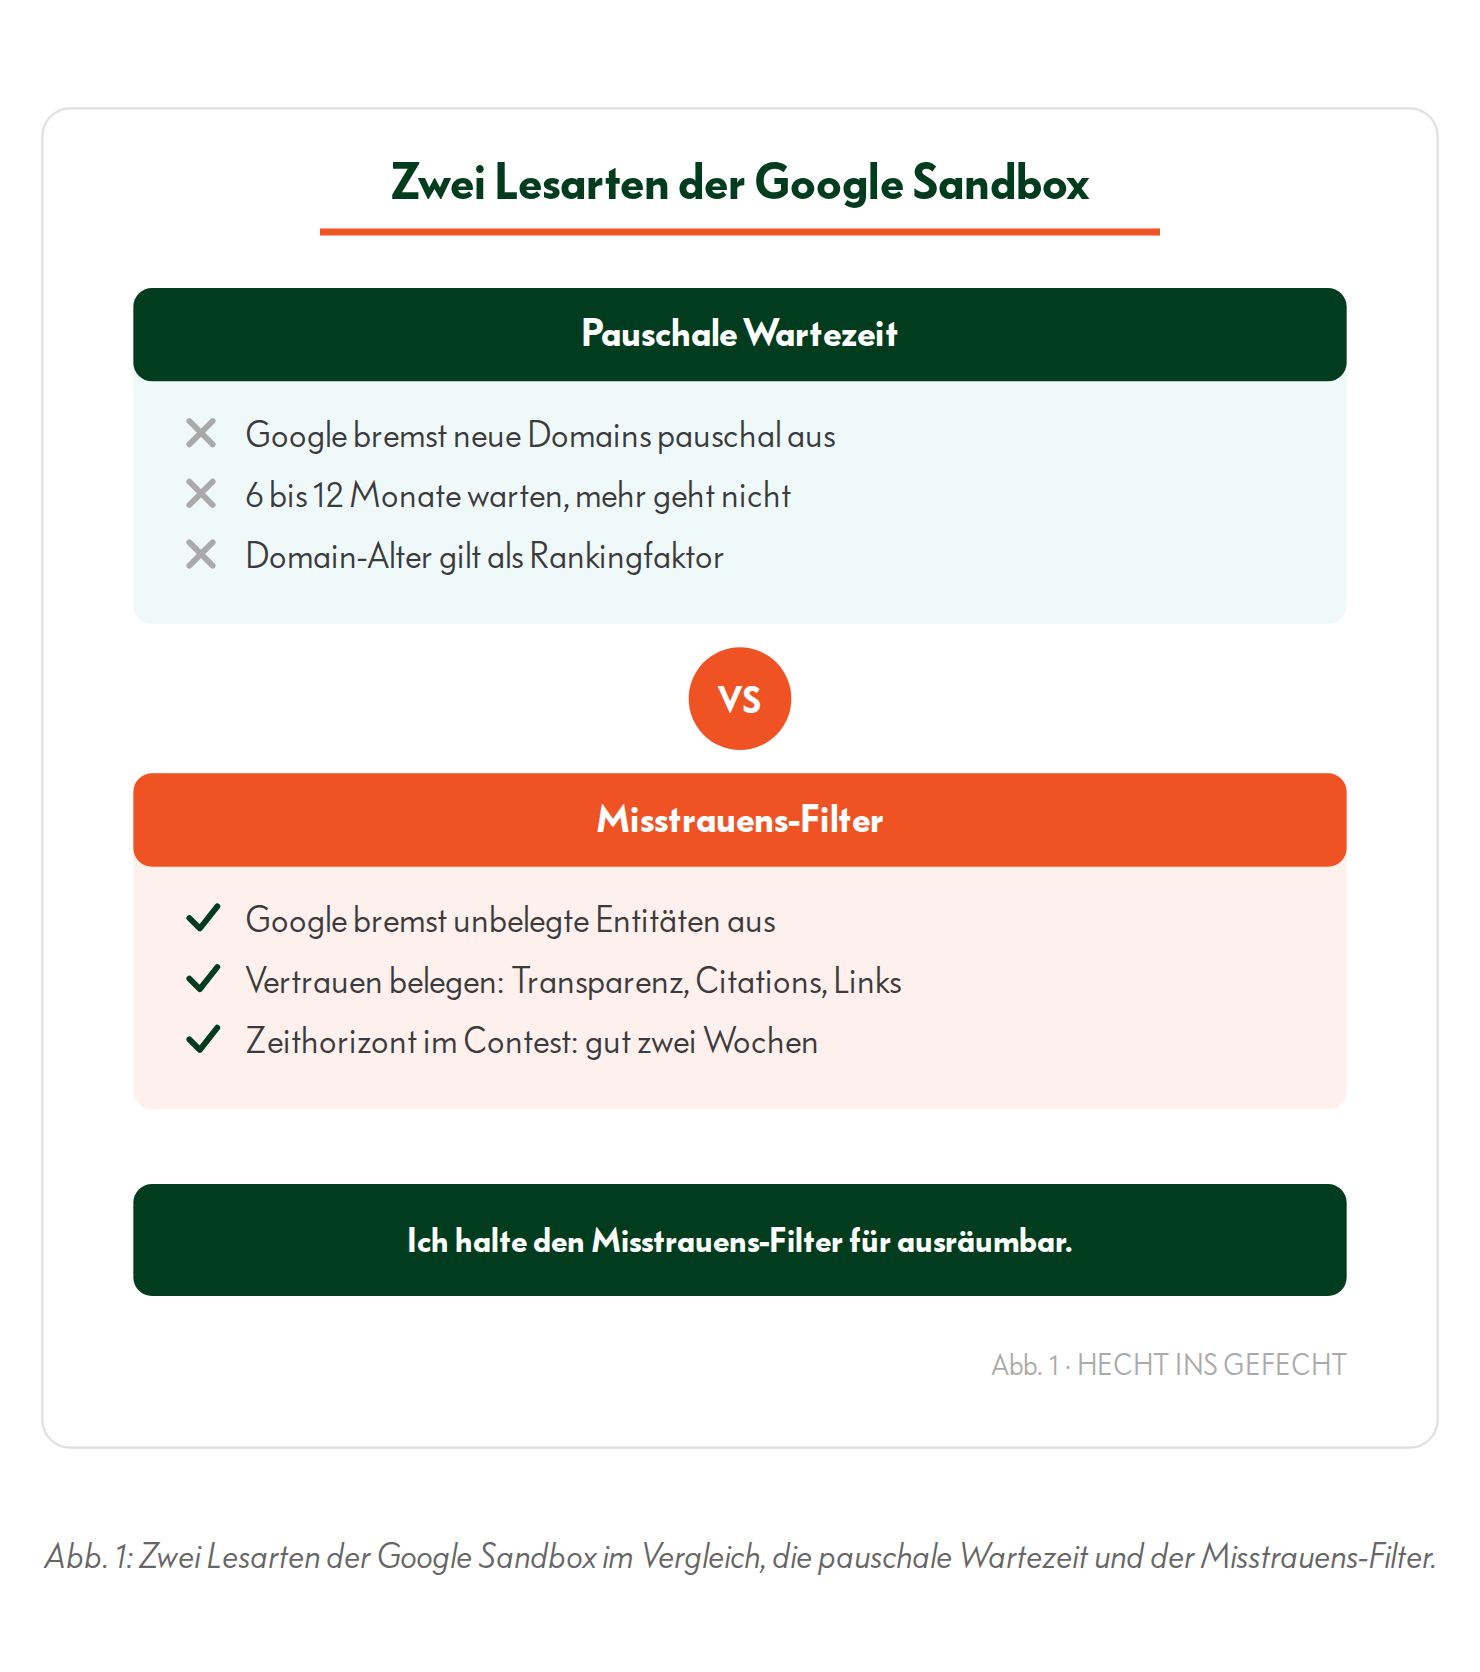
Nach zwei SEO-Contests mit frischen Domains halte ich die Google Sandbox für einen Misstrauens-Filter, der unbelegte Entitäten ausbremst. Eine Entität ist dabei etwa eine Marke oder Firma, die Google eindeutig erkennen kann. Einen solchen Misstrauens-Filter kannst du aktiv ausräumen.
Inhalt
Was hinter der Google Sandbox steckt
Die Google Sandbox bezeichnet eine angebliche Anlaufphase von 6 bis 12 Monaten, in der neue Domains trotz guter Inhalte kaum ranken. Google hat die Google Sandbox zwischen 2016 und 2021 mehrfach dementiert. Einen unabhängigen Nachweis kenne ich nicht. Der Google-Leak von 2024 liefert aus meiner Sicht ein starkes Indiz für einen Spam-Mechanismus bei frischen Hosts. Einen pauschalen Filter für alle neuen Domains zeigen die bekannten Auszüge des Leaks nicht.
Der US-Fachjournalist Barry Schwartz protokolliert die Google-Aussagen dazu seit Jahren auf Search Engine Roundtable. Gary Illyes, Analyst im Google-Search-Team, twitterte im Dezember 2016: „we don’t have a Google sandbox“. John Mueller, Search Advocate bei Google, twitterte im August 2019: „There is no sandbox“.
2020 erklärte Illyes im Google-Podcast „Search Off the Record“, die Sandbox von 2004 sei wohl ein Effekt der damaligen Indexierung gewesen. Nach seiner Darstellung habe Google den Index damals nur einmal im Monat neu aufgebaut. Wer zur falschen Zeit startete, habe lange gewartet.
Aufschlussreicher finde ich, was Mueller in den SEO Office Hours im Mai 2021 ergänzte. Google trifft bei neuen Inhalten Annahmen, weil noch Daten fehlen. Fällt die Schätzung zu optimistisch aus, rankt eine neue Seite kurz erstaunlich gut, ein Verlauf, der im SEO-Bereich Honeymoon-Effekt heißt.
Fällt die Schätzung zu vorsichtig aus, hängt die Seite unten fest. In derselben Antwort sagte Mueller, Google bevorzuge oder bremse neue Inhalte nicht gezielt.
Ende Mai 2024 bekam die Debatte neues Material. Rand Fishkin, Mitgründer von SparkToro, und Mike King, Gründer der SEO-Agentur iPullRank, veröffentlichten Analysen geleakter interner API-Dokumentation aus Googles Content Warehouse. Das Material umfasst über 2.500 Seiten mit 14.014 Attributen. Darin steht ein Attribut namens hostAge, laut Beschreibung dafür da, frischen Spam auszubremsen („to sandbox fresh spam in serving time“).
King kommentierte den Fund mit dem Zitat „Turns out there is a sandbox after all.“ Er schrieb im Mai 2024 auch, Muellers Dementi-Tweet von 2019 sei inzwischen gelöscht.
Außerdem schrieb King, Google speichere die jüngsten Registrierungsdaten einer Domain, und vermutete einen Zusammenhang mit dem Ausbremsen neuer Inhalte. Google bestätigte gegenüber The Verge die Echtheit der Dokumente. Zugleich warnte Google vor Schlüssen aus unvollständigen, veralteten oder aus dem Zusammenhang gerissenen Informationen.
Entscheidend ist die Formulierung im Leak, denn es geht dort um frischen Spam. Dass ein Mechanismus neue Hosts kritisch prüft, halte ich für plausibel. Eine pauschale Sperre für alle neuen Domains ist etwas anderes.
Deswegen greifen beide Positionen in der Debatte zu kurz. Wer heute noch sagt, die Sandbox existiere nicht, übergeht den Leak. Wer neue Domains 6 bis 12 Monate warten lässt, macht aus einem Spam-Filter eine feste Wartezeit.
Meiner Lesart nach ist die Google Sandbox ein Misstrauens-Filter gegen unbelegte Entitäten. Google hält zurück, was es noch nicht einordnen kann. Belegt ist diese Mechanik nicht. Der Leak zeigt zwar ein Attribut für das Host-Alter, aber keine Gewichte. Und Google trennt Crawling, Indexierung und Ranking, jede Stufe kann aus eigenen Gründen zurückhalten.
Abb. 1: Zwei Lesarten der Google Sandbox im Vergleich, die pauschale Wartezeit und der Misstrauens-Filter. ↓ PNG
Woher der Rat zur Geduld kommt
Wer zur Google Sandbox recherchiert, bekommt im deutschsprachigen Raum meist denselben Rat: Geduld. Schon 2005 sprachen Teilnehmer im Forum WebmasterWorld von 6, später 9 und zuletzt 12 Monaten. Bei einer Stichprobe von HECHT INS GEFECHT im Oktober 2026 unter den Google-Treffern zu drei Suchbegriffen rund um „google sandbox“ nannten 6 von 10 deutschsprachigen Ratgebern eine Zeitspanne. Meist lautete sie 3 bis 12 Monate, für Gesundheits- und Finanzthemen setzte einer 9 bis über 12 Monate an.
Zahlen, die zur Geduld passen, liefert eine Studie von Patrick Stox, damals Product Advisor bei Ahrefs, vom Mai 2025. Danach standen nur 1,74 % neuer Seiten binnen 12 Monaten in den Top 10. Die durchschnittliche Nummer-1-Seite war rund 5 Jahre alt.
Aus diesen Zahlen eine Wartezeit für neue Domains abzuleiten, halte ich für falsch. Die Ahrefs-Studie misst, dass die meisten neuen Seiten langsam ranken. Gemessen hat sie zufällige neue Seiten auf beliebigen Domains, auch auf alten. Warum sie langsam ranken, misst sie nicht, und einen Filter beweist sie erst recht nicht.
Nach zwei Contest-Kampagnen lese ich die 1,74 % anders und sehe darin vor allem, wie die meisten neuen Seiten starten. Die typische neue Seite hat keine klar beschriebene Entität, keine Citations (Einträge in Profilen und Verzeichnissen), keine autoritativen Signale und oft obendrein dünnen Content. Dass alte Seiten oben stehen, zeigt in erster Linie, dass ihre Autorität Zeit zum Wachsen hatte. Mueller verneinte 2017 die Frage, ob das Domain-Alter ein Rankingfaktor sei.
Warum ranken neue Domains in der Praxis dann so oft monatelang nicht? In der Regel deshalb, weil nach meiner Erfahrung das Vertrauensproblem der neuen Domain in den ersten Monaten unbearbeitet bleibt.
Der Praxisbeweis: Platz 1 in 21 Tagen, gestartet bei Domain Rating 0
Am 9. Juni 2026 riefen Seobility und Agenturtipp.de das fiktive Contest-Keyword „Serponado“ aus. Am selben Vormittag habe ich für HECHT INS GEFECHT serponado.org registriert und noch am Abend eine schlanke HTML-Website live gestellt. Am 30. Juni stand die Domain auf Platz 1. Endergebnis laut offizieller Auswertung: 9,93 Punkte und Platz 1 in fünf von sechs Einzelwertungen, über Desktop und Mobile hinweg.
Zu einem fiktiven Keyword gibt es keine Seiten, die seit Jahren ranken. Beim Keyword startete das Feld bei null, mit drei Wochen Zeit für etwa 200 SEO-Agenturen, Freelancer sowie Inhouse-SEOs. Viele Teilnehmer traten mit Unterseiten bestehender Agentur-Websites an, darunter mehrere Agenturen aus den Top 10 der Endwertung.
Für mich war es der zweite Anlauf mit diesem Ansatz. Beim Contest 2025 holte keywordkoenig.org, ebenfalls erst zum Keyword-Ausruf registriert, Platz 3.
Tag 1 im Access-Log: die ersten Crawler am Launch-Abend
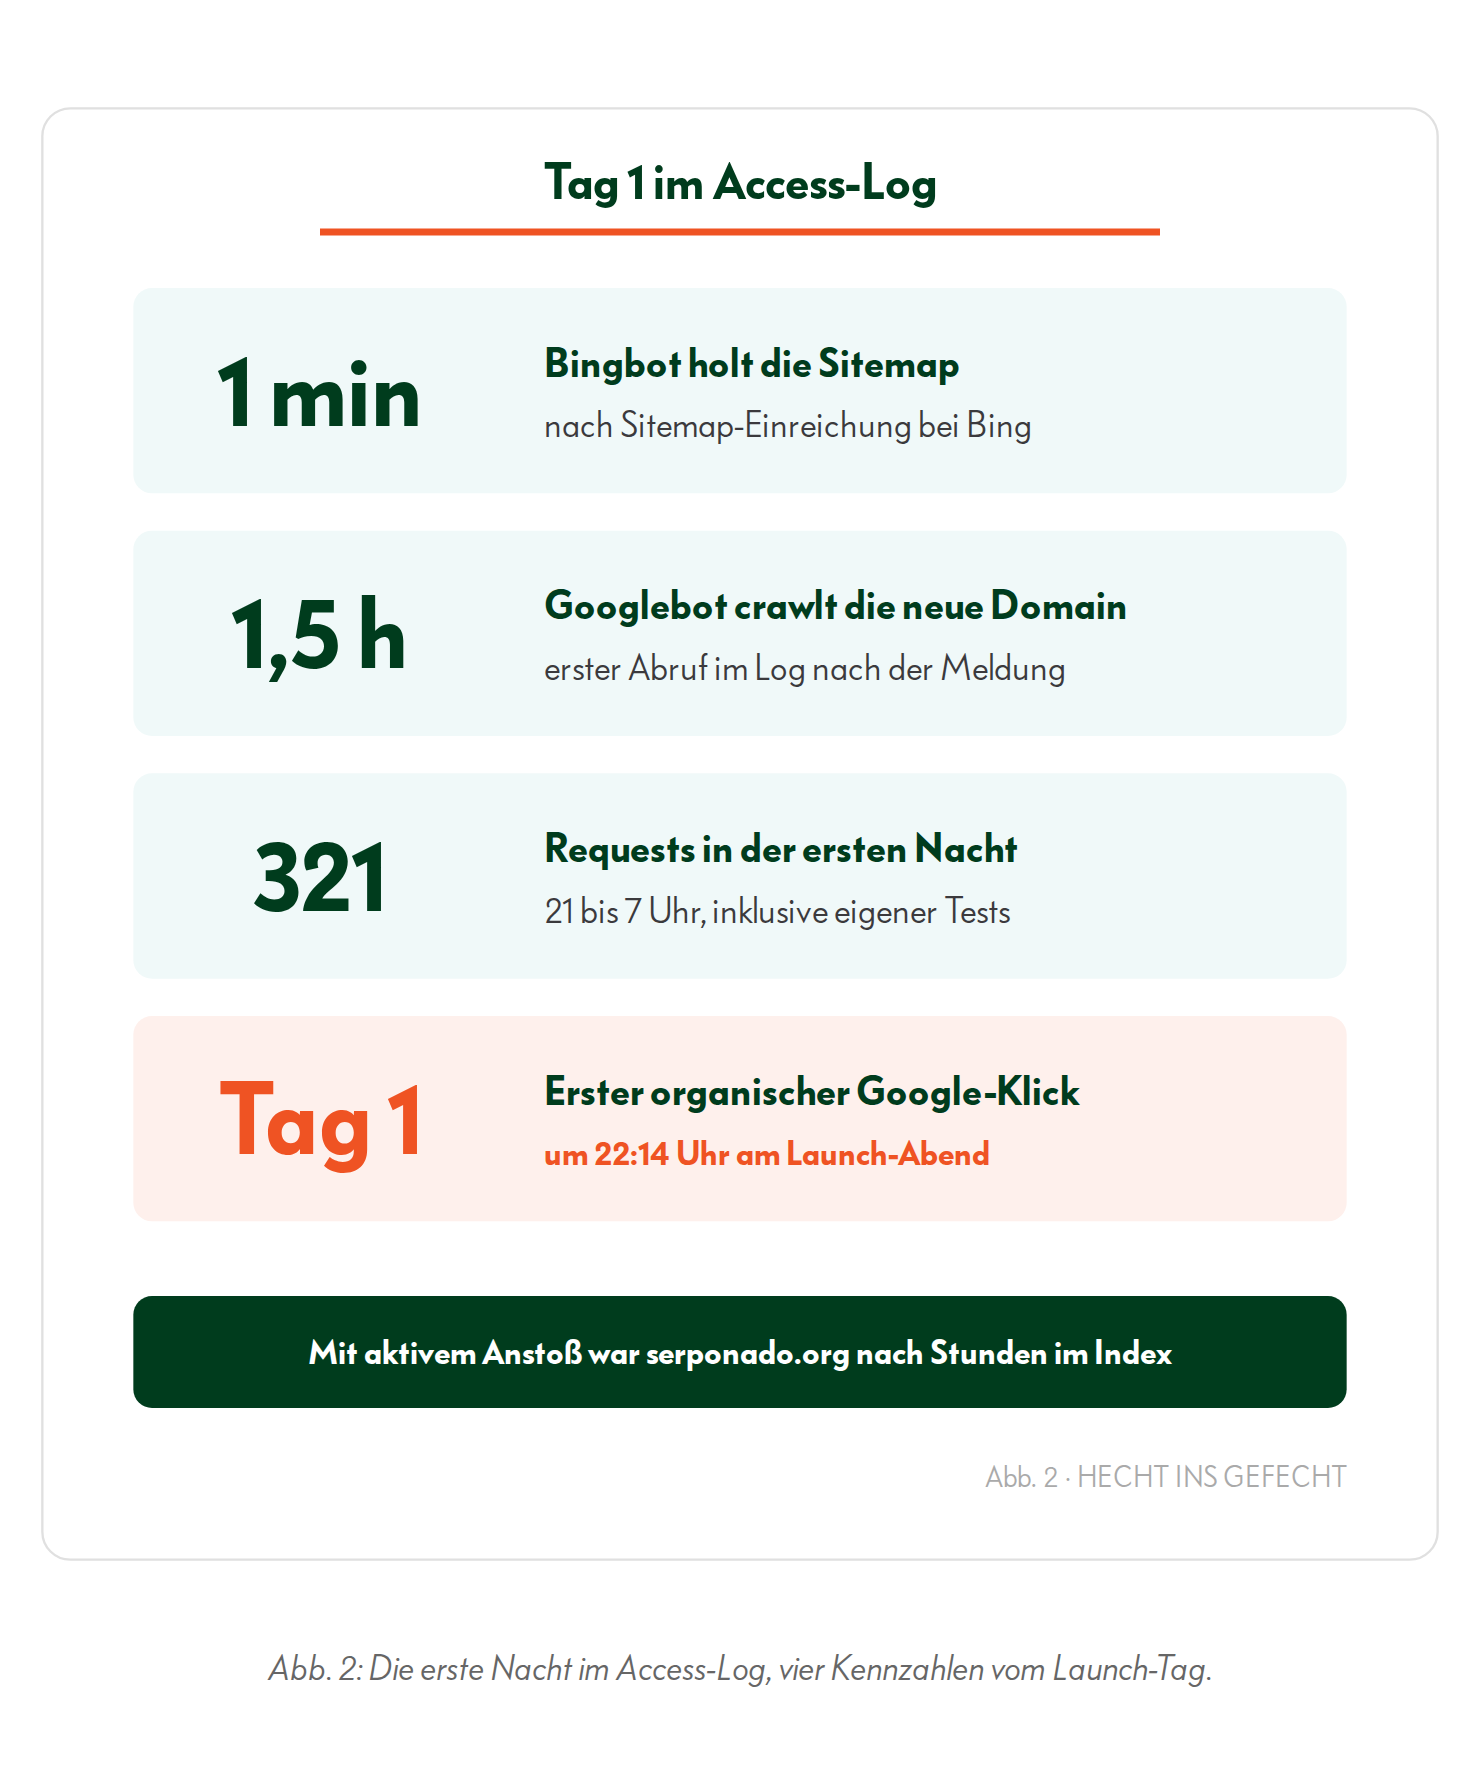
Die erste Nacht steht im Server-Log, das allerdings erst ab 21:02 Uhr lief. Bis 7 Uhr am nächsten Morgen standen 321 Requests im Log, eigene Testabrufe eingeschlossen. Um 20:38 Uhr hatte ich die neuen URLs gemeldet. Der Bingbot holte die Sitemap um 21:03 Uhr ab, binnen einer Minute nach einer erneuten Einreichung in den Bing Webmaster Tools.
Der Googlebot tauchte um 22:02 Uhr zum ersten Mal im Log auf, knapp 90 Minuten nach der Meldung per Indexing API. Ob er vorher schon da war, zeigt das Log nicht. ClaudeBot, der Crawler von Anthropic, holte ab Tag 1 etwa alle zwei Stunden robots.txt und Sitemap. Um 22:14 Uhr kam der erste Klick aus der organischen Google-Suche.
Ehrlicherweise kam davon nichts von allein. Ich habe die Domain aktiv angemeldet: IndexNow und die API für Bing, dazu Search Console und Indexing API für Google. Offiziell ist die Indexing API nur für Stellenanzeigen und Livestreams gedacht, in der Praxis stößt sie den Crawler an, vorausgesetzt die Berechtigung stimmt.
Mit Inhaber-Rechten in der Search Console klappt es. Mit reinem Vollzugriff antwortet die API mit einem 403. Werkzeuge, die den Fehlercode nicht auswerten, verbuchen solche Submits trotzdem als Erfolg. Google schreibt, ein Missbrauch der API könne zum Entzug des Zugangs führen.
Der Beitrag zur Indexierung zeigt Schritt für Schritt, wie du neue URLs bei Google und Bing anstößt. Mit Anstoß war die Aufnahme in den Index bei serponado.org eine Sache von Stunden. Nach meiner Erfahrung liegt sie in der Regel bei Stunden bis Tagen. Ohne Anstoß kann sich dieselbe Aufnahme über Wochen ziehen, und diese Wartezeit wird dann der Sandbox zugeschrieben.
Abb. 2: Die erste Nacht im Access-Log, vier Kennzahlen vom Launch-Tag. ↓ PNG
12. bis 18. Juni: Das Tal, das wie die Sandbox aussah
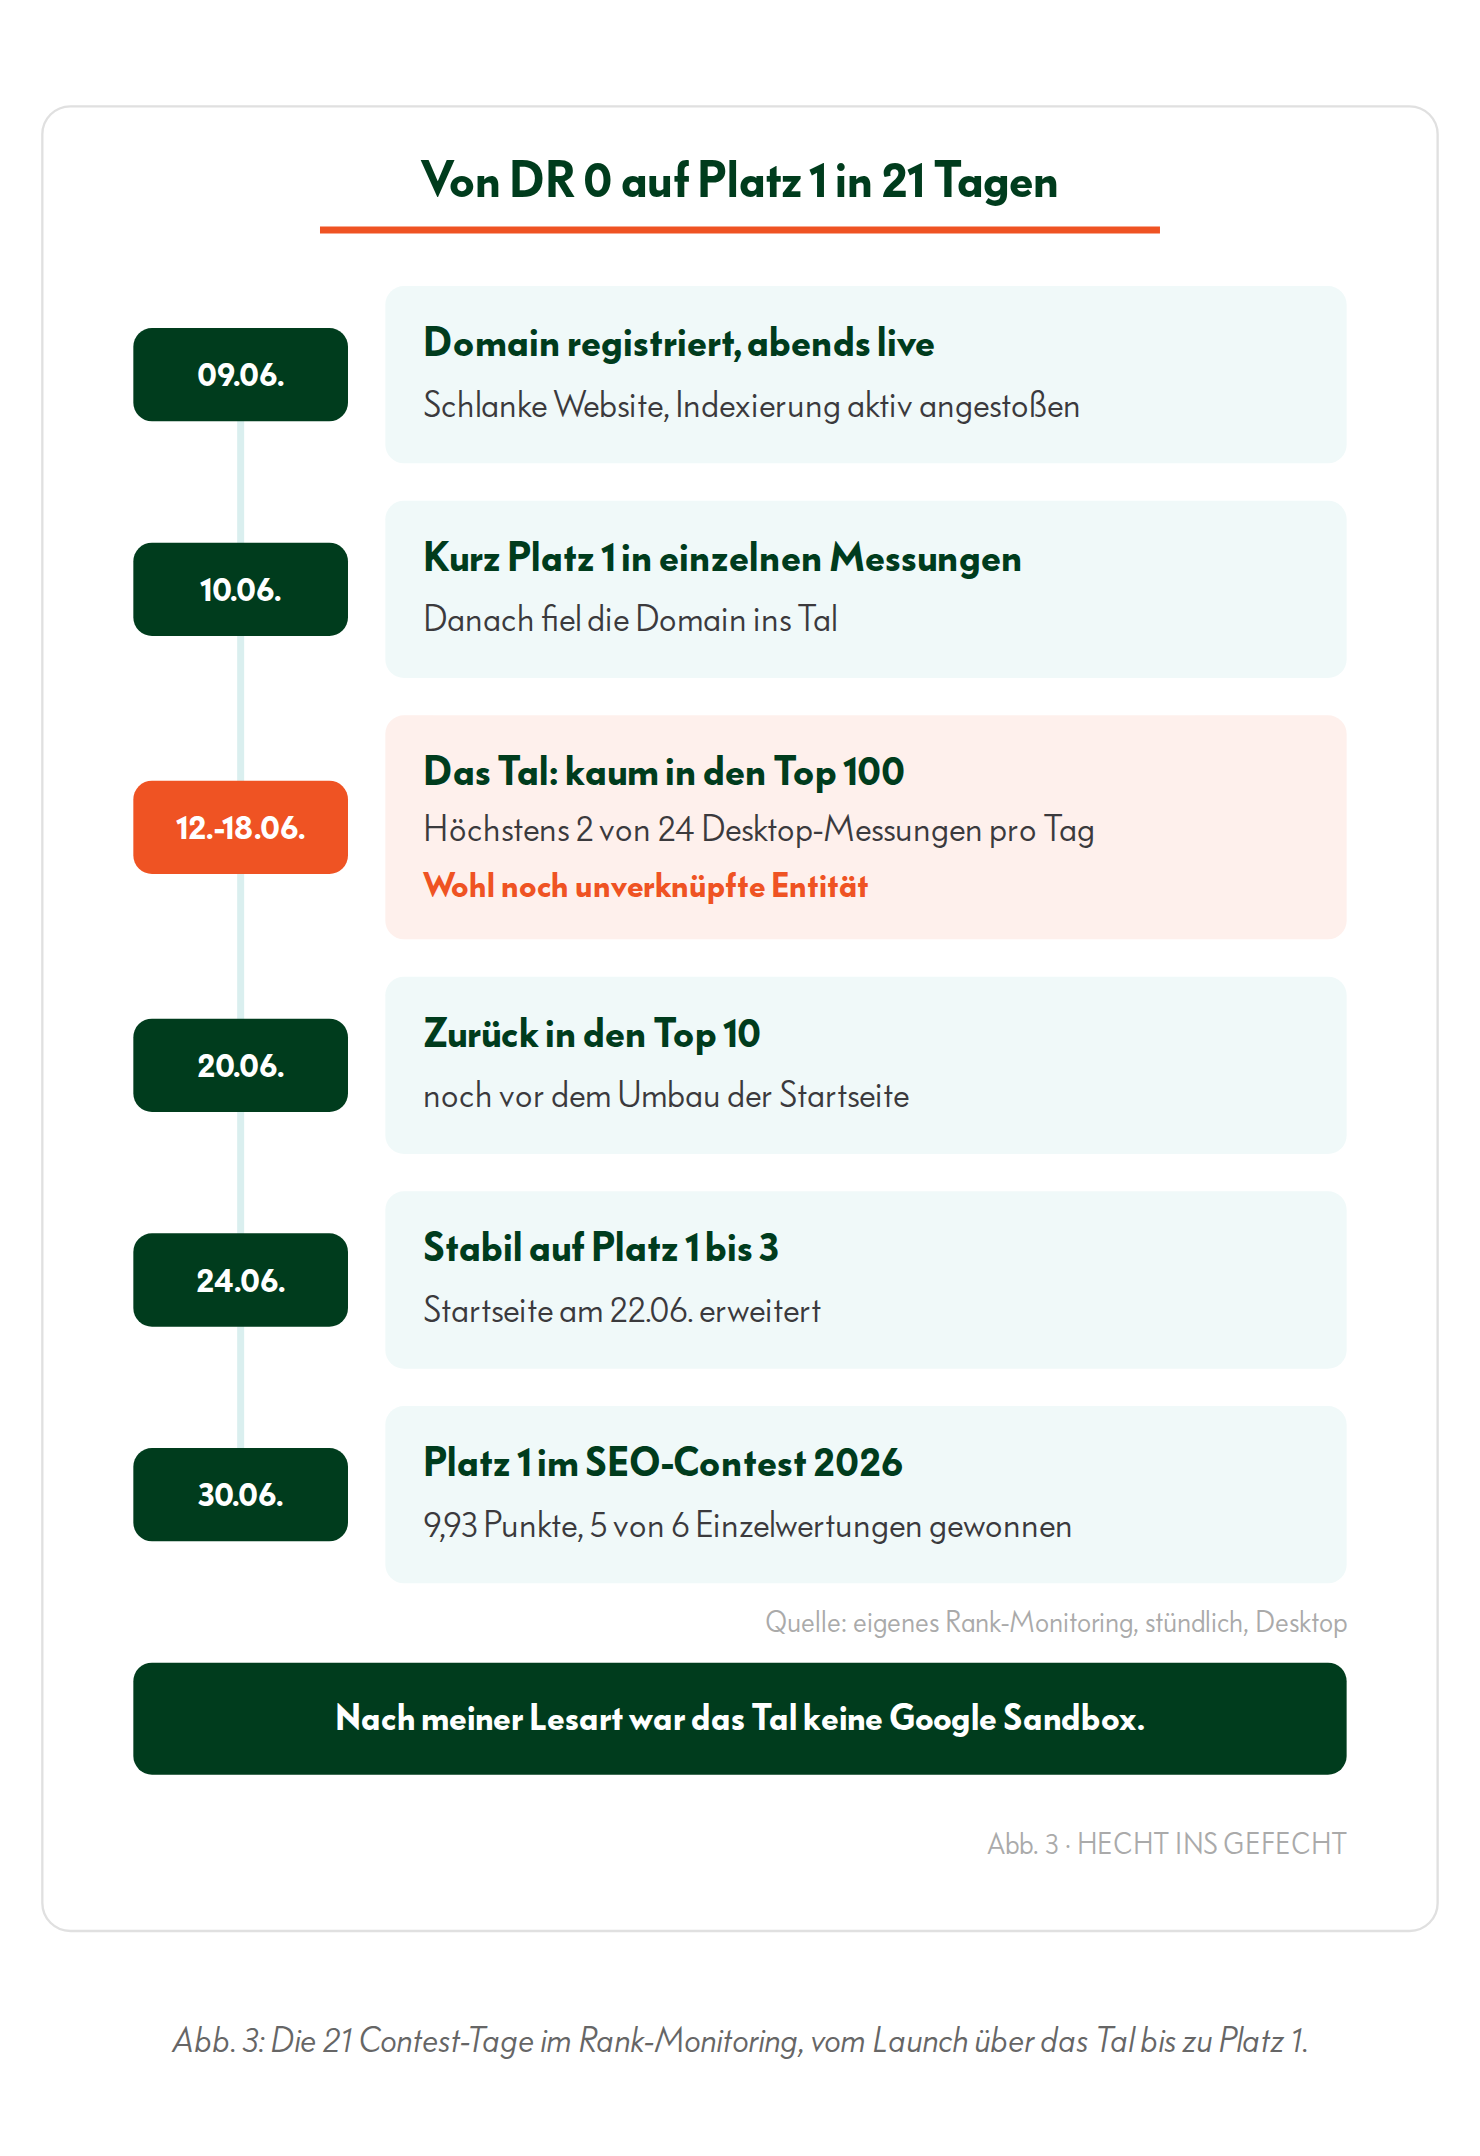
Am Tag nach dem Launch stand die Domain in einzelnen Messungen kurz auf Platz 1, danach ging es steil nach unten. Vom 12. bis 18. Juni tauchte serponado.org in höchstens 2 von rund 24 stündlichen Desktop-Messungen pro Tag in den Top 100 auf. War das die Google Sandbox? Nach meiner Einschätzung nicht, drei andere Erklärungen liegen näher.
Erstens tauchten binnen weniger Tage hunderte neue Seiten zum Keyword in den Suchergebnissen auf. Die Top 10 wechselten von Stunde zu Stunde. Zweitens waren meine Citations zwar angelegt, also die Firmenprofile bei Crunchbase, in Branchenverzeichnissen und auf Kartendiensten. Nach meiner Einschätzung hatte Google sie der Domain aber noch nicht zugeordnet. Die Profile und die Website existierten für Google getrennt voneinander.
Drittens war die Seite am 10. Juni ab 18 Uhr wegen eines Ausfalls beim Hoster rund 55 Minuten nicht erreichbar. Das Tal begann gut einen Tag später. Ob der Ausfall nachwirkte, ist offen. Aus meiner Sicht hat keiner der drei Gründe mit dem Alter der Domain zu tun.
Rückkehr in die Top 10 und Platz 1
Ab dem 20. Juni war die Domain zurück in den Top 10 und hing dort erst einmal im Mittelfeld fest. Nach meiner Einschätzung lag der Grund in den Top-Ergebnissen. Das Kunstwort hatte durch die Contest-Beiträge eine eigene Bedeutung als SERP-Phänomen bekommen, das heißt als Phänomen in den Suchergebnissen. Meine Startseite beschrieb aber weiterhin nur die Marke.
Am 22. Juni habe ich die Startseite deswegen um die Konsens-Bedeutung als SERP-Phänomen erweitert. Nach meiner Einschätzung griffen parallel die Citation-Signale. Ab dem 24. Juni stand die Domain stabil auf Platz 1 bis 3 und war in der Schlusswoche in fast jeder Messung präsent.
Ob der Bedeutungs-Umbau den Ausschlag gab oder die Citations, lässt sich nicht sauber trennen. Die Rückkehr in die Top 10 begann schon zwei Tage vor dem Umbau. Nach meiner Lesart wirkte beides in dieselbe Richtung und half Google, die Entität einzuordnen.
In der letzten Woche habe ich bewusst keine neuen Maßnahmen mehr gestartet, Stabilität war mir an dem Punkt wichtiger als ein weiterer Hebel.
Abb. 3: Die 21 Contest-Tage im Rank-Monitoring, vom Launch über das Tal bis zu Platz 1. ↓ PNG
Die Linkprofile im Check: alle 15 frischen Contest-Domains bei Rating 0
Mitte Juni habe ich 15 der rund 20 frisch zum Kunstwort registrierten Domains im Contest durch Ahrefs gejagt, serponado.org eingeschlossen. Alle 15 standen auf Domain Rating 0, auf einer Linkprofil-Skala, die bis 100 reicht. Bei allen 15 waren rund 90 % der verweisenden Domains derselbe automatisch erzeugte Spam. Aus dem Domain Rating ließen sich die Ranking-Unterschiede zwischen diesen Domains also nicht erklären.
Der Blick auf das Gesamtfeld bestätigte das. In den Top 10 standen zeitweise frisch registrierte Domains mit Rating 0 neben großen Plattformen wie YouTube, Wikipedia und Facebook mit Rating über 90.
In den Linkprofilen der 15 frischen Domains fanden sich nur wenige echte Quellen. Die zwei stärksten zeigten auf serponado.org: ein Crunchbase-Profil (Domain Rating 91) und ein Karteneintrag (Domain Rating 74). Beide Links trugen laut Ahrefs das Attribut nofollow. Google behandelt nofollow als Hinweis. Welcher Anteil Linkwert floss, lässt sich nicht isolieren.
Nach meiner Einschätzung wirkten beide Quellen vor allem als Belege für die Entität. Solche Einträge sind Entity-Korroboration, das heißt unabhängige Quellen mit denselben Angaben zur selben Marke. Mehr dazu steht im Beitrag über Entity SEO.
Zwei eigene Fehler und zwei Indexierungsfälle aus dem Blog
Richtig Zeit gekostet haben mich zwei eigene Fehler, und beide hatten mit dem Domain-Alter nichts zu tun. Das Item in der freien Wissensdatenbank Wikidata habe ich am ersten Tag angelegt. Knapp zwei Tage später löschte es ein Admin, weil es die Relevanzkriterien von Wikidata nicht erfüllte. Meine Lehre daraus lautet, erst unabhängige Fundstellen aufzubauen und dann Wikidata anzulegen.
Fehler zwei war eine Unterseite, die eine Sektion der Startseite fast wortgleich doppelte. Die Search Console zeigte „Gecrawlt, zurzeit nicht indexiert“. Nach sechs Tagen habe ich sie per 301 auf die Startseite umgeleitet.
Duplicate Content ist laut Google kein Verstoß gegen die Spam-Richtlinien. Bei Null-Autorität führt er aber dazu, dass Google redundante Seiten gar nicht erst priorisiert. Duplicate Content bei Null-Autorität ist nach meiner Erfahrung eine der stärksten Bremsen junger Domains. Eine etablierte Website verkraftet solche Redundanzen meist besser.
Ganz immun sind aber auch etablierte Domains nicht. Auch dort wählt Google nach URL aus, was in den Index kommt. Das GEO-Agentur-Listicle von HECHT INS GEFECHT war 23 Tage nach der Veröffentlichung im Juli 2026 noch nicht gecrawlt. Es stand in der Sitemap, und zwei Submits liefen.
Die Search Console zeigte „Gefunden, zurzeit nicht indexiert“. Das Listicle überschnitt sich thematisch mit dem bestehenden SEO-Agentur-Listicle. Nach dem Umzug auf eine neue URL per 301 war es am nächsten Tag indexiert, mit 922 Impressionen in der ersten Woche.
Umgekehrt kam eine Seite ohne URL-Wechsel zurück. Der Beitrag zur LLM-Sichtbarkeit von HECHT INS GEFECHT fiel im Juni 2026 auf „Gecrawlt, zurzeit nicht indexiert“, obwohl die Technik sauber war. Nach 30 Korrekturen und einem Submit war er ohne URL-Wechsel wieder im Index.
Ob die Korrekturen oder der Submit den Ausschlag gaben, lässt sich nicht trennen. Die Impressionen stiegen von 13 im Juni auf 4.952 im August.
Warum neue Domains wirklich nicht ranken
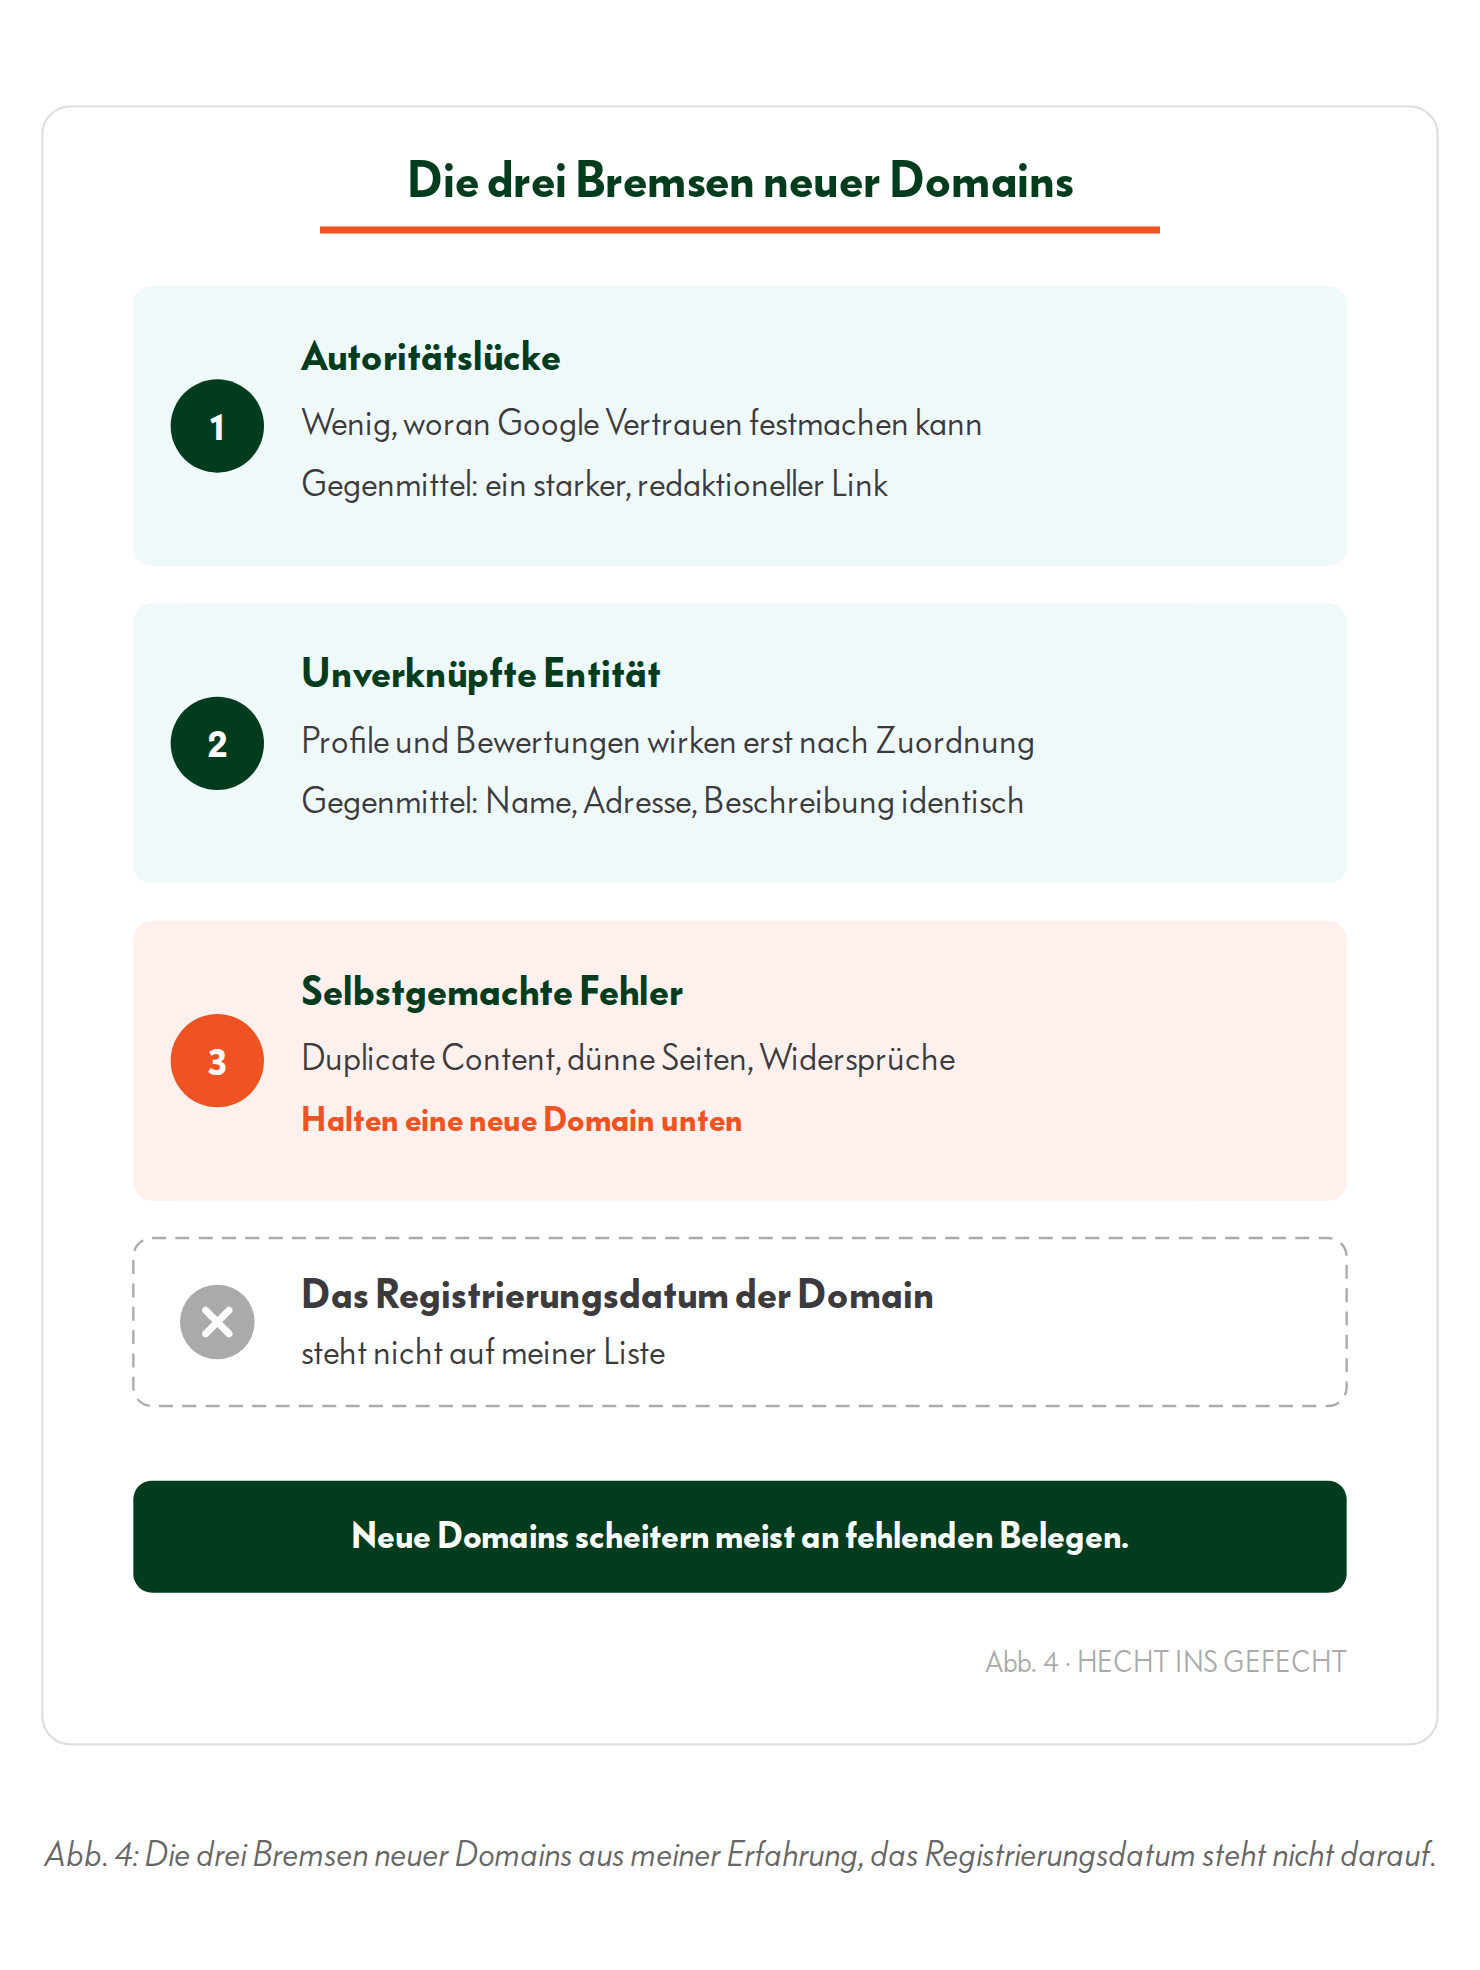
Nach meiner Erfahrung scheitern neue Domains an drei Bremsen: Autoritätslücke, unverknüpfte Entität, selbstgemachte Fehler wie Duplicate Content bei Null-Autorität. Das Registrierungsdatum der Domain steht nicht auf meiner Liste, obwohl der Leak ein Attribut für das Host-Alter zeigt.
Die erste Bremse sind fehlende autoritative Signale. Eine frische Domain bietet Google wenig, woran sich Vertrauen festmachen lässt. Ein einziger starker, redaktioneller Link von einer autoritativen Website kann diese Lücke schließen, nach meiner Überzeugung auch auf umkämpften Märkten. Garantiert ist das nicht. Links wirken im Ranking neben vielen anderen Signalen, und deren Gewichte kennt außerhalb von Google niemand.
Bremse Nummer zwei ist die unverknüpfte Entität. Profile, Bewertungen und Verzeichniseinträge wirken erst, wenn Google sie derselben Marke zuordnet. Bei serponado.org dauerte die Zuordnung nach meiner Einschätzung rund zwei Wochen. In diese Zeit fiel das Ranking-Tal vom 12. bis 18. Juni. Beschleunigen lässt sich die Zuordnung mit Konsistenz: überall derselbe Name, dieselbe Adresse, dieselbe Beschreibung.
Die dritte Bremse produzierst du selbst: Duplicate Content, dünne Seiten oder widersprüchliche Angaben. Eine etablierte Domain verkraftet solche Fehler meist besser, eine neue Domain können sie lange unten halten.
Abb. 4: Die drei Bremsen neuer Domains aus meiner Erfahrung, das Registrierungsdatum steht nicht darauf. ↓ PNG
Die Brand-Ausnahme: wo die Sandbox nie greift
Für den eigenen, eindeutigen Markennamen rankt eine neue Domain nach meiner Erfahrung in der Regel schnell. Das gilt, wenn niemand sonst auf den Namen optimiert.
Im Contest habe ich das Keyword von Tag 1 an wie eine Marke behandelt. Domain, Title, H1, Schema und Profile beschrieben alle dieselbe Agentur namens Serponado. Diese Brand-Ausnahme galt im Contest nur eingeschränkt, weil rund 200 Teilnehmer auf dasselbe Wort optimierten.
Übertragbar ist die Brand-Logik auf echte Projekte mit eigenem Begriff, auf den anders als im Contest niemand sonst optimiert. Naming ist letztlich eine SEO-Entscheidung. Wer ein Produkt oder eine Kategorie mit einem eigenen, eindeutigen Begriff benennt, hat bei diesem Begriff anfangs kaum Konkurrenz. Mehr dazu steht im Beitrag über Brand SEO.
Nach meiner Einschätzung hat originärer Content, nach dem tatsächlich gesucht wird, wegen der geringen Konkurrenz auch ohne Backlinks wenig von einer Sandbox zu befürchten.
Wo Geduld berechtigt ist
YMYL steht für Your Money or Your Life. Google nennt so Themen, die Gesundheit, finanzielle Sicherheit, die Sicherheit von Menschen oder das Wohl der Gesellschaft erheblich beeinflussen können. Bei diesen Themen geben Googles Systeme starken E-E-A-T-Signalen noch mehr Gewicht. E-E-A-T steht für Erfahrung, Expertise, Autorität und Vertrauenswürdigkeit.
Aus meiner Sicht braucht der Vertrauensaufbau dort mehr und bessere Belege und dauert länger. Eine fixe Wartezeit folgt daraus nicht.
Der Contest-Fall hat Grenzen. Bei einem fiktiven Keyword fehlen die alten Wettbewerber, die seit Jahren ranken. Auf echten Märkten mit etablierten, gut verlinkten Wettbewerbern verschiebt sich der Engpass zu den autoritativen Signalen, und der Zeithorizont wird länger. Nach meiner Einschätzung bleibt entscheidend, wie schnell du Belege lieferst.
Der Entity-Sprint: Vertrauen belegen statt Zeit absitzen
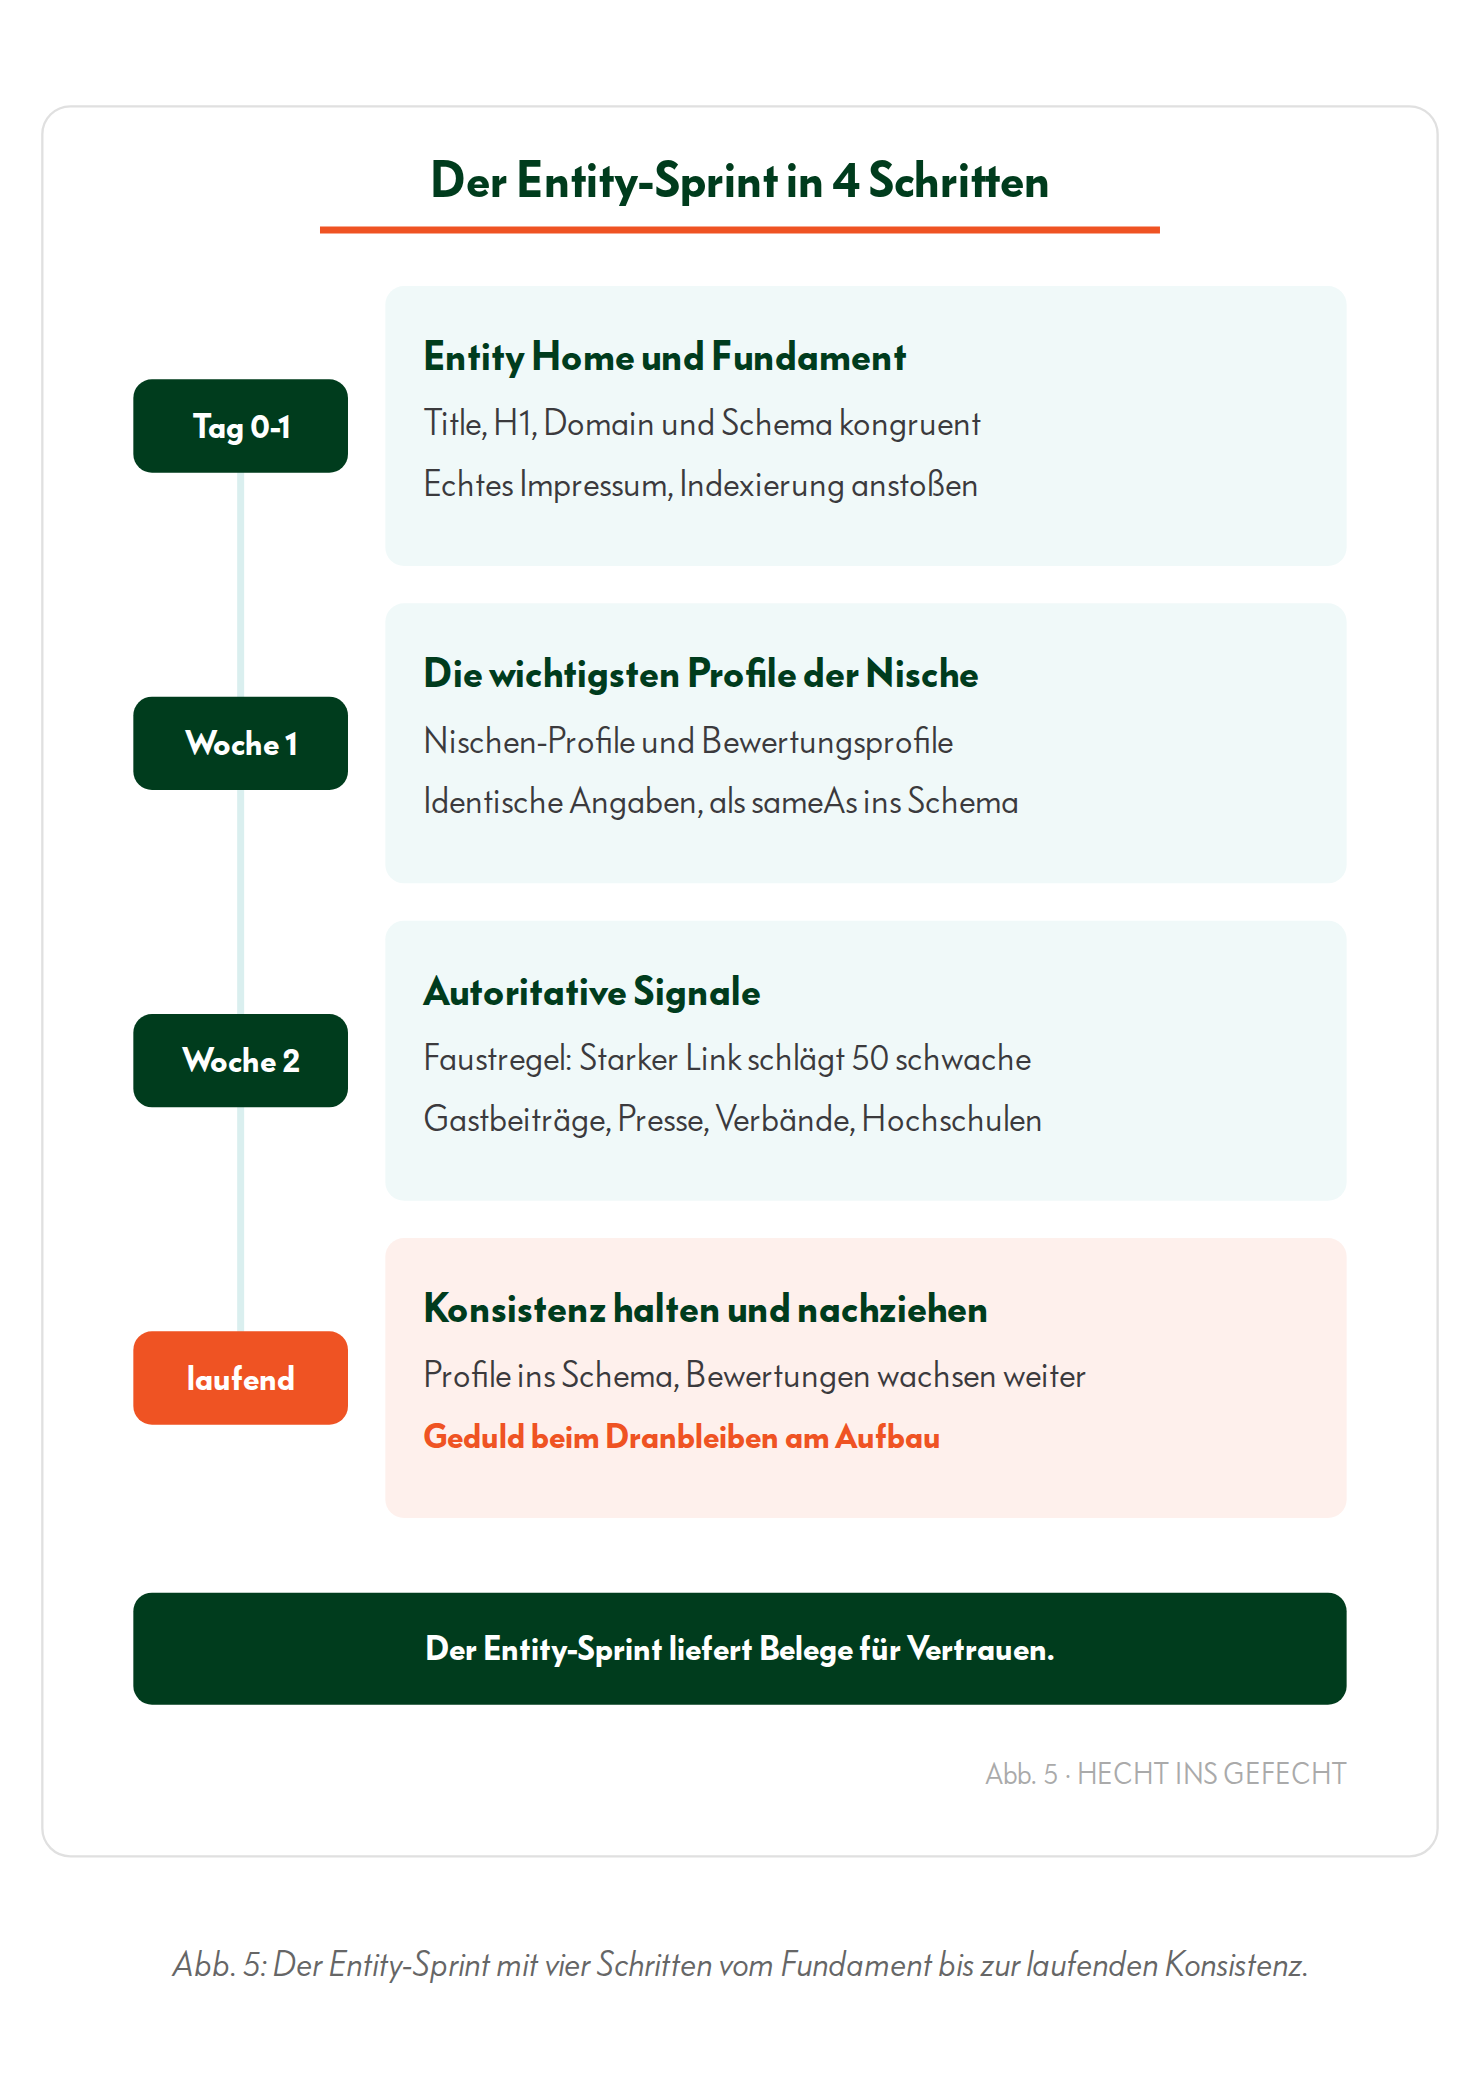
Der Entity-Sprint ist mein Vorgehen in 4 Schritten, mit dem eine neue Domain in wenigen Wochen die nötigen Vertrauensbelege bekommen soll. Meine Annahme dahinter ist, dass ein Spam-Filter vor allem Seiten bremst, die wie Spam aussehen. Spam-Websites nennen auf der Website oft keinen Betreiber, machen auf verschiedenen Kanälen widersprüchliche Angaben und haben selten echte Bewertungen. Eine vertrauenswürdige Entität macht im Impressum und in den Profilen echte Angaben und zeigt auf allen Kanälen dieselbe Beschreibung.
Schritt 1 (Tag 0 bis 1): Entity Home und Fundament
Die eigene Website ist das Entity Home, die zentrale Seite, die die Marke beschreibt. Sie macht in den ersten Sätzen unmissverständlich klar, wer oder was die Marke ist. Title, H1, Domain und Organization-Schema tragen dieselbe Botschaft, das Prinzip dahinter erklärt der Beitrag zur Über-uns-Seite als Entity-Hub. Technisch bleibt die Website schlank und schnell, nach dem Prinzip des Cost of Retrieval.
Ins Impressum gehören nach § 5 DDG echter Name, echte Anschrift, eine E-Mail-Adresse und ein weiterer schneller Kontaktweg. Eine Telefonnummer ist nicht vorgeschrieben, ich empfehle sie trotzdem.
Danach stößt du die Indexierung aktiv an, per IndexNow und Search Console. Bei serponado.org stand das Fundament am Abend des ersten Tages.
Schritt 2 (erste Woche): die wichtigsten Profile der Nische
Bau zuerst die Profile auf, die in deiner Nische Gewicht haben. Bewertungsprofile wie Google, ProvenExpert oder Trustpilot gehören ebenfalls dazu, wie im Beitrag zum Bewertungsmanagement beschrieben.
Jedes Profil bekommt identische Angaben (gleicher Name, gleiche Adresse, gleiche Telefonnummer, gleiche Beschreibung). Es wandert als sameAs ins Schema, als Verweis, dass Profil und Website dieselbe Marke beschreiben. Übernommene Bewertungsprofile helfen dir außerdem, wenn ein Wettbewerber gefälschte Bewertungen platziert.
Pro-Tipp: Prüfe nach zwei Wochen per site:-Abfrage, welche deiner Profile tatsächlich im Google-Index stehen. Ein Profil, das nicht im Index steht, kann Google über die Websuche nicht als Beleg lesen. Die site:-Abfrage zeigt laut Google nicht immer alle indexierten URLs, ein fehlender Treffer ist nur ein Hinweis. Der Knowledge Graph, Googles Wissensdatenbank über Entitäten, nutzt zwar auch strukturierte Quellen und lizenzierte Daten von Partnern. Auf die hast du bei Profilen aber kaum Einfluss.
Schritt 3 (zweite Woche): autoritative Signale
Nach meiner Faustregel schlägt ein starker Link 50 schwache. Gastbeiträge in Fachmedien, Presseerwähnungen, Verbands- oder Hochschulseiten bringen einer neuen Domain schnell Autorität. Bezahlte Gastbeiträge mit Links, die Rankingwert weitergeben, zählt Google laut seiner Spam-Richtlinie zum Link-Spam, wenn die Links nicht als gesponsert oder nofollow gekennzeichnet sind.
Falls solche Links kurzfristig unrealistisch sind, ist die Expired Domain eine Option, mit den Risiken einer fremden Link-Historie. Ob Google die alten Links nach dem Inhaberwechsel noch wertet, ist offen. Mueller nannte 2022 viele abgelaufene, neu genutzte Domains SEO-Treibgut, und seit März 2024 hat Google eine eigene Spam-Richtlinie gegen den Missbrauch abgelaufener Domains. Wie das funktioniert, steht im Beitrag über Expired Domains.
Schritt 4 (laufend): Konsistenz halten und nachziehen
Schritt 4 läuft dauerhaft weiter. Neue Profile wandern ins Schema, Bewertungen wachsen, und die Indexierung prüfst du regelmäßig nach. Geduld brauchst du also doch, allerdings beim Dranbleiben am Aufbau.
Bei serponado.org dauerte der Vertrauensaufbau nach meiner Einschätzung gut zwei Wochen, auf umkämpften Märkten dauert er länger.
Abb. 5: Der Entity-Sprint mit vier Schritten vom Fundament bis zur laufenden Konsistenz. ↓ PNG
Mein Fazit
Der Sandbox-Mechanismus aus dem Leak soll laut Beschreibung frischen Spam ausbremsen, eine feste Wartezeit für neue Domains zeigt er nicht. Nach meiner Erfahrung reagierst du darauf mit Arbeit: echte Angaben im Impressum und in den Profilen, echte Bewertungen, auf allen Kanälen dieselbe Beschreibung.
Bei serponado.org lag der Schwerpunkt auf Entity- und On-Page-Arbeit. Bei der Ahrefs-Messung Mitte Juni 2026 lagen alle 15 geprüften Contest-Domains bei Domain Rating 0. Das erklärt die Ranking-Unterschiede nicht, und welchen Anteil Links hatten, lässt sich nicht isolieren. Die frische Domain gewann in 21 Tagen den SEO-Contest 2026.
Der Mitveranstalter Seobility nennt den Contest den größten deutschsprachigen SEO-Wettbewerb. Für HECHT INS GEFECHT war das nach Platz 3 im Contest 2025 die zweite Top-3-Platzierung in Folge.
Gibt es die Google Sandbox wirklich?
Google hat die Google Sandbox zwischen 2016 und 2021 mehrfach dementiert. Der Google-Leak von 2024 zeigt aber ein Attribut namens hostAge, das laut Beschreibung frischen Spam ausbremsen soll. Weder die Dementis noch der Leak belegen eine pauschale Wartezeit für alle neuen Domains.
Wie lange dauert es, bis eine neue Domain bei Google rankt?
Mit aktivem Anstoß stand serponado.org am Launch-Abend im Index und tags darauf kurz auf Platz 1. Stabile Positionen erreichte sie nach meiner Einschätzung im Contest nach gut zwei Wochen, auf umkämpften Märkten dauert es länger.
Wie umgehe ich die Google Sandbox?
Die Grundlage nimmst du dem Spam-Filter mit echten Angaben im Impressum und in den Profilen, echten Bewertungen und mindestens einem autoritativen Signal. Nach meiner Einschätzung behandelt der Filter eine Domain, die Google eindeutig einer vertrauenswürdigen Entität zuordnen kann, nicht wie Spam.
Rankt eine neue Domain auch ohne Backlinks?
Für den eigenen, eindeutigen Markennamen rankt eine neue Domain nach meiner Erfahrung in der Regel schnell, auch ohne Backlinks. Voraussetzung dafür ist, dass niemand sonst auf den Namen optimiert. Bei umkämpften Begriffen zählen wenige autoritative Signale mehr als viele schwache.
Was bremst neue Domains am stärksten?
Am stärksten bremsen nach meiner Erfahrung fehlende autoritative Signale, eine unverknüpfte Entität und Duplicate Content bei Null-Autorität. Das Registrierungsdatum allein steht nicht auf dieser Liste, obwohl der Google-Leak ein Attribut für das Host-Alter zeigt.
Quellen
- Agenturtipp.de: SEO-Contest 2026, das sind die Gewinner (Juli 2026)
- Agenturtipp.de: „Keywordkönig“ gekrönt, SEO-Contest 2025 entschieden (Juni 2025)
- Mike King (iPullRank): Secrets from the Google Algorithm Leak (Mai 2024)
- Rand Fishkin (SparkToro): An Anonymous Source Shared Thousands of Leaked Google Search API Documents (Mai 2024)
- Barry Schwartz (Search Engine Land): Google responds to leak: Documentation lacks context (Mai 2024)
- Mia Sato (The Verge): Google confirms the leaked Search documents are real (Mai 2024)
- Roger Montti (Search Engine Journal): Mueller Touches on Google Sandbox and Honeymoon Ranking Effects (Mai 2021)
- Barry Schwartz (Search Engine Roundtable): Google: There Is No Google Sandbox (Dezember 2016)
- Barry Schwartz (Search Engine Roundtable): Google Says Domain Age Doesn’t Matter For Search Rankings (April 2017)
- Barry Schwartz (Search Engine Roundtable): Google: There Is No Sandbox (August 2019)
- Barry Schwartz (Search Engine Roundtable): Google: The 2004 Sandbox Ranking Theory Was Likely About Indexing (August 2020)
- Barry Schwartz (Search Engine Roundtable): Google: Expired & Repurposed Domains Are SEO-Flotsam (Dezember 2022)
- WebmasterWorld: Longest You’ve Been in the Sandbox? (Mai 2005, Archivkopie)
- Patrick Stox (Ahrefs): How Long Does It Take to Rank in Google? And How Old Are Top Ranking Pages? (Mai 2025)
- Google Search Central: Kurzanleitung für die Indexing API
- Google Search Central: Spamrichtlinien für die Google Websuche
- Google Search Central Blog: What web creators should know about our March 2024 core update and new spam policies (März 2024)
- Google Search Central: Hilfreiche, vertrauenswürdige, nutzerorientierte Inhalte erstellen
- Seobility und Agenturtipp.de: SEO Contest 2026
- Google Search Central: Suchoperator „site:“ verwenden
- Gesetze im Internet: § 5 DDG, Allgemeine Informationspflichten